给 AI Agent 开一个文章发布接口
一、缘起:让 Agent 自己把文章发出去
这个技术站点平时由我维护,写文章的人是我,发文章的人也是我。但每次发文的流程是这样的:整理好正文,手动登录后台,新建文章,粘贴 HTML,选栏目,填摘要关键词,传图,最后点发布。
如果只是偶尔发一篇,这个流程完全没问题。但当发文变成常态——尤其是当文章本身就是由 AI 生成的时候——「人肉搬运」就成了整条链路上最慢、最容易出错的一环。粘错栏目、漏填摘要、图片传了却没插进正文,都是真实发生过的事。
于是有了这个接口:让 Agent 直接通过 HTTP 把文章写进 CMS,去掉中间的人工环节。
不过这里有个前提:站点是基于 SIYUCMS(ThinkPHP)搭的现成 CMS,不是自己写的应用。所以接口是在既有 CMS 之上加的一层薄封装,而不是重写一套内容系统。
二、整体设计:四个接口,一条流水线
接口拆成了四步,每一步只做一件事:
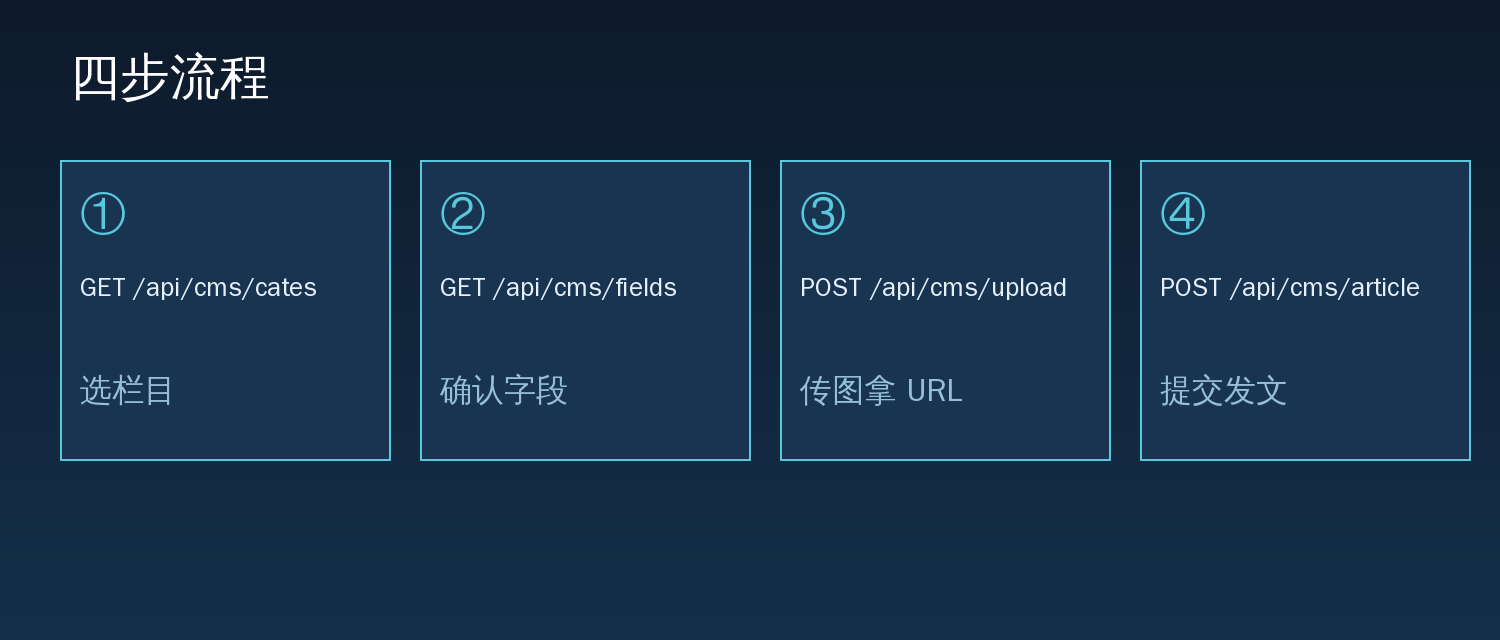
① GET  /api/cms/cates                  → 拿可发布栏目列表,选定 cate_id
② GET  /api/cms/fields?cate_id=<id>    → 拿该栏目要填的字段清单与上传配置
③ POST /api/cms/upload                 → 上传头图/配图,拿到图片 URL
④ POST /api/cms/article → 提交文章,拿到 id 与访问地址之所以拆成四步而不是一个大而全的「一步发文」接口,核心原因是让调用方不依赖任何硬编码。后面会展开讲。
三、鉴权:一个静态 Token
鉴权用的是最朴素的方式:请求头带一个静态 Token。
X-Api-Token: <token>

# 也兼容标准写法
Authorization: Bearer <token>
选静态 Token 而不是 OAuth 或者签名机制,是基于实际场景的权衡:
- 调用方是可信的——目前只有我这边的 Agent 在用,不存在多方授权、权限分级的需求
- Token 泄了可以立刻换——服务端更换即让旧 Token 全部失效,不需要复杂的吊销流程
- 实现成本低——一个请求头校验,不用维护令牌签发、刷新、过期整套机制
当然代价也很清楚:静态 Token 没有时效性,一旦泄露就是长期有效。所以对应的防护措施是——Token 不写进代码、不进版本库、不贴进聊天记录,统一放在服务端的环境变量文件里由脚本读取。文档里也只放占位符。
如果将来需要对外开放,这套鉴权就不够用了,届时该上的是签名 + 时效 + 权限分级,而不是继续加长 Token。
四、栏目与字段查询:不要硬编码
这是整个设计里最重要的一条原则。
CMS 的栏目是会变的——今天有「PHP」「Python」「前端」八个栏目,明天可能加一个「数据库」,或者把某个栏目改成单页模型(不再支持发文章)。如果调用方把栏目 id 和字段表写死在代码里,那么每次后台调整,调用方就得跟着改一次。
所以接口设计成调用方先问、再发:
GET /api/cms/cates
→ [{"id": 16, "cate_name": "前端", "cate_folder": "FrontEnd",
     "model_name": "Article", "list_url": "/index/FrontEnd.html"}, ...]

GET /api/cms/fields?cate_id=16
→ {"fields": [
     {"field": "title",   "name": "标题", "type": "text",     "required": true},
     {"field": "content", "name": "内容", "type": "editor",   "required": false},
     ...
   ],
   "upload": {"url": "/api/cms/upload", "field_name": "file",
              "allow_ext": ["jpg","png","gif","jpeg","ico"]}}
这样带来两个好处:
- 后台改了,调用方不用改——栏目新增、字段调整,接口返回的就是最新的
- 必填项由服务端说了算——哪些字段必填、哪些可以留空,以接口返回为准,不会因为前端猜错而导致提交失败
顺带一提,fields 接口还会顺带返回上传配置(允许的图片后缀、大小上限)。这样调用方在传图之前就知道哪些格式会被拒,不用靠试错。
五、图片上传:必须先传到站点
图片走独立的上传接口,字段名单张用 file、多张用 file[]:
POST /api/cms/upload
Content-Type: multipart/form-data

file=@cover.png

→ {"code": 1, "data": {
     "url": "/uploads/20260920/803ec9b5...png",
     "urls": ["/uploads/20260920/803ec9b5...png"]
}}返回的是相对路径(以 / 开头),可以直接原样写进 image 字段和正文的 <img src>,前台会自动拼上域名。
这里有两条必须遵守的规则:
- 正文和头图只能引用本站地址——直接填外站图片链接可能不显示或被过滤,所以外链图要先下载到本地再上传
- 服务端会校验真实图片内容——把非图片文件改个扩展名是过不了的,这个校验做在上传环节而不是仅靠后缀判断
另外 alt 属性建议必填。除了无障碍阅读,它对 SEO 也有实际作用——图片的语义信息搜索引擎只能从这里读。
六、文章提交:字段与 HTML
提交接口接收 JSON,字段与后台表单一一对应:
| 字段 | 说明 |
|---|---|
cate_id | 栏目 id(必填) |
title | 标题,≤255 字符(必填) |
content | 正文 HTML(图片嵌在这里) |
summary | 摘要,留空会自动截正文前 120 字 |
image | 头图 URL |
tags / keywords | 标签与 SEO 关键词 |
status | 1=发布,0=草稿 |
sort | 排序,越大越靠前 |
正文是原样渲染的 HTML 片段,这一点需要调用方特别注意。写的时候要注意:
- 正文最高层级用
<h2>——页面大标题已经占位,正文里再用<h1>会出现两个一级标题 - 不要内联
style属性——会被站点样式覆盖或破坏排版,样式统一由模板控制 - 不要提交完整 HTML 文档——只交正文片段,
<html>、<head>这些不需要
响应里会返回新文章的 id 和 url,方便调用方直接给出文章链接。
七、为什么只开放新增
这个接口刻意不提供修改和删除能力。
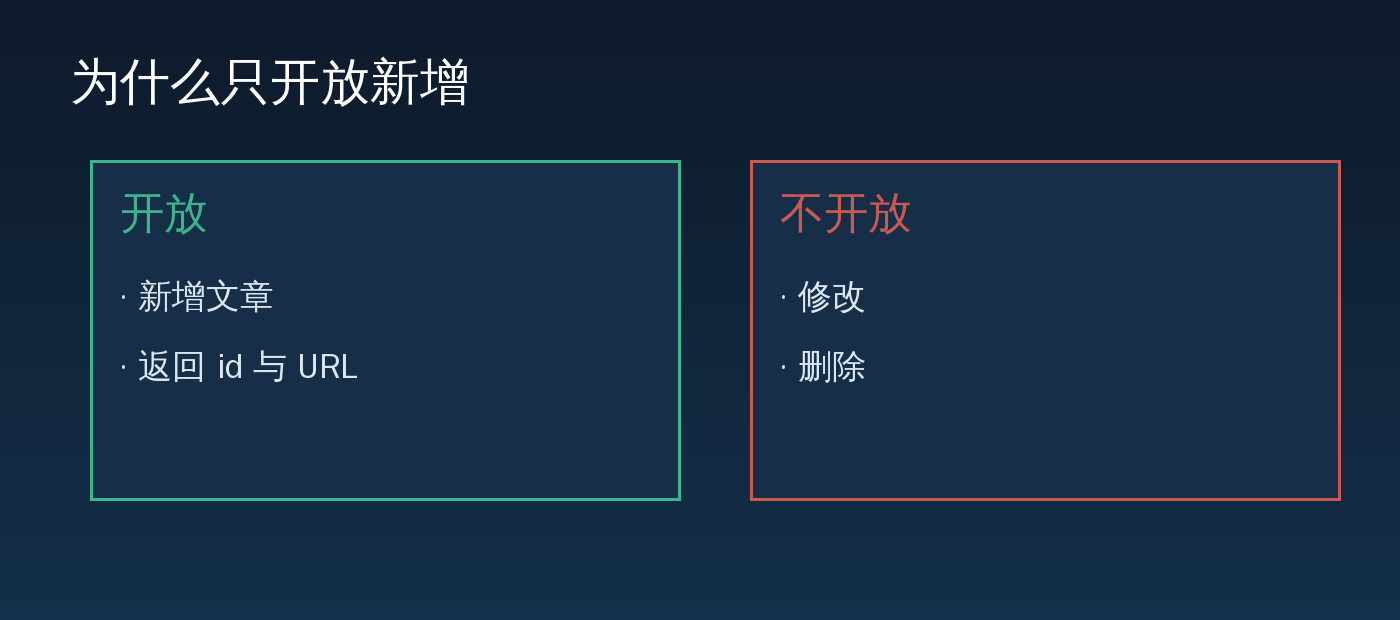
看起来是个限制,实际上是基于风险的主动设计:
- 删除是不可逆的——文章一旦被误删,连带评论、收录、外链全部失效。把删除能力交给一个可能误判的自动化流程,风险远大于收益
- 修改的语义很复杂——是覆盖全文还是增量更新?草稿和已发布要不要区分?这些语义一旦定义不好,很容易出现「改了一半」的状态。与其设计一个半吊子的更新接口,不如先不做
- 新增是幂等性可控的——重复提交只会多一篇文章,不会破坏已有数据。最坏的情况是清理一条多余记录,而不是丢失历史内容
这个取舍带来一个必须遵守的纪律:接口返回成功后绝不重试。因为接口不支持去重,网络抖动时如果盲目重发,站点上就会多出一条重复文章。
需要修改文章时怎么办?目前的方案是去后台手动改,或者重新发一条替代。对于自动化流程来说,「只能往前加」比「可以随意改」更容易做出可靠的行为——这跟数据库里的 append-only 日志是同一个道理。
八、踩过的坑
开发和使用过程中遇到几个值得记下来的问题:
8.1 判成功要看响应体,不能看 HTTP 状态码
接口的统一响应结构是 {"code": 1, "msg": "OK", "data": {}},其中 code 为 1 才算成功。关键在于——失败时 HTTP 状态码可能仍然是 200。
只判断 response.status_code == 200 的调用方,会把「栏目不存在」这种业务失败当成成功。正确做法是解析响应体检查 code 字段。
8.2 404 不一定是 Token 问题
接口刚上线时访问返回的是 ThinkPHP 的「系统发生错误」HTML 页面,而不是 JSON。当时第一反应是 Token 写错了,但仔细看返回的是 404 且根本不是 JSON——说明请求压根没匹配到路由,跟鉴权无关。
排查方向应该在路由注册、控制器文件是否上传、Nginx 伪静态是否覆盖 /api 路径,而不是反复检查 Token。经验是:返回格式不对,先怀疑路由;返回格式对但 code=0,才怀疑业务。
8.3 不要用测试文章验证接口
因为接口不能删除,用一篇「测试标题」的文章来验证链路,这篇测试数据就永久留在站点上了。
正确做法是用一条真实内容走完整流程——反正都要发,不如第一篇就发真的。
8.4 头图别为了凑比例裁出断字
用官方新闻图做头图时,常遇到原图宽高比不标准的问题。为了凑成 16:10 硬裁,很容易把图片上的文字切成 …ase III Trial of 这样的断头词——比比例不标准难看得多。
结论是:宁可保留完整文字、接受非标准比例,也不要出现残字。如果确实需要裁,别靠肉眼估边界,用像素分析定位文字区域更靠谱。
九、小结
这个接口本身不复杂——四个端点、一个静态 Token、一层薄薄的 CMS 封装。但它在「AI 生成内容」这件事上补上了一块关键拼图:让内容的产出和发布之间不再需要人工中转。
回头看,几个设计决策值得保留下来:
- 接口分步而非大而全——调用方先问再发,避免硬编码栏目与字段
- 鉴权按实际威胁模型选型——可信调用方场景下,静态 Token 够用,不必过度设计
- 能力边界要主动收窄——只开放新增,把不可逆操作挡在自动化之外
- 成功判断以业务字段为准——HTTP 状态码只表示传输层结果
给自动化流程开放写权限时,限制它能做什么,比教它别做错更可靠。接口层面不给删除能力,比在提示词里反复叮嘱「不要删文章」要稳得多。