一个人怎么管十个自动化任务:Hermes 实战
一、一个人,和一堆必须定期做的事
小团队里做技术,最典型的困境是:人少、事杂、但每件事都不能断。
要定期采集数据、要出周期报表、要盯着几个服务别挂、要跟进政策更新、要在出问题时第一时间知道。这些事单拎出来都不难,难的是每件都要人记得去做——而人总会忘。
我目前的做法是把这些事全部交给定时任务,自己在这些流程里的角色从"执行者"变成"验收者"。这篇文章记录的就是这套自动化是怎么搭起来、踩过哪些坑。
二、核心思路:让脚本干活,让 Agent 兜底
很多人一说到"AI 自动化",第一反应是让 AI 去干所有事。但实际跑下来,最稳的结构是这样的:
定时触发  →  脚本执行(确定性任务)  →  只在异常时才惊动 AI / 人
              ↓
         正常时静默,什么都不发
关键原则:能写成脚本的,就不要交给 AI。
原因有三个:
- 确定性——脚本每次执行结果一致,AI 可能这次对下次错
- 成本——脚本跑一百次也是零成本,AI 每跑一次都要花钱
- 可审计——出问题时能看日志定位,AI 的中间过程是黑盒
AI 应该出现在真正需要判断的地方:内容理解、异常归因、报告撰写、自然语言交互。而不是用来做"每十分钟检查一次端口通不通"这种事。
三、Watchdog 模式:零 token 的服务守护
这是我认为最值得推广的一个模式。
传统做法是让 AI 每隔一段时间去检查服务状态,有问题就报告。这个做法的缺点是每次检查都要调用一次模型——一天 144 次检查,绝大多数时候什么事都没有,但 token 照烧。
Watchdog 模式把逻辑反过来:
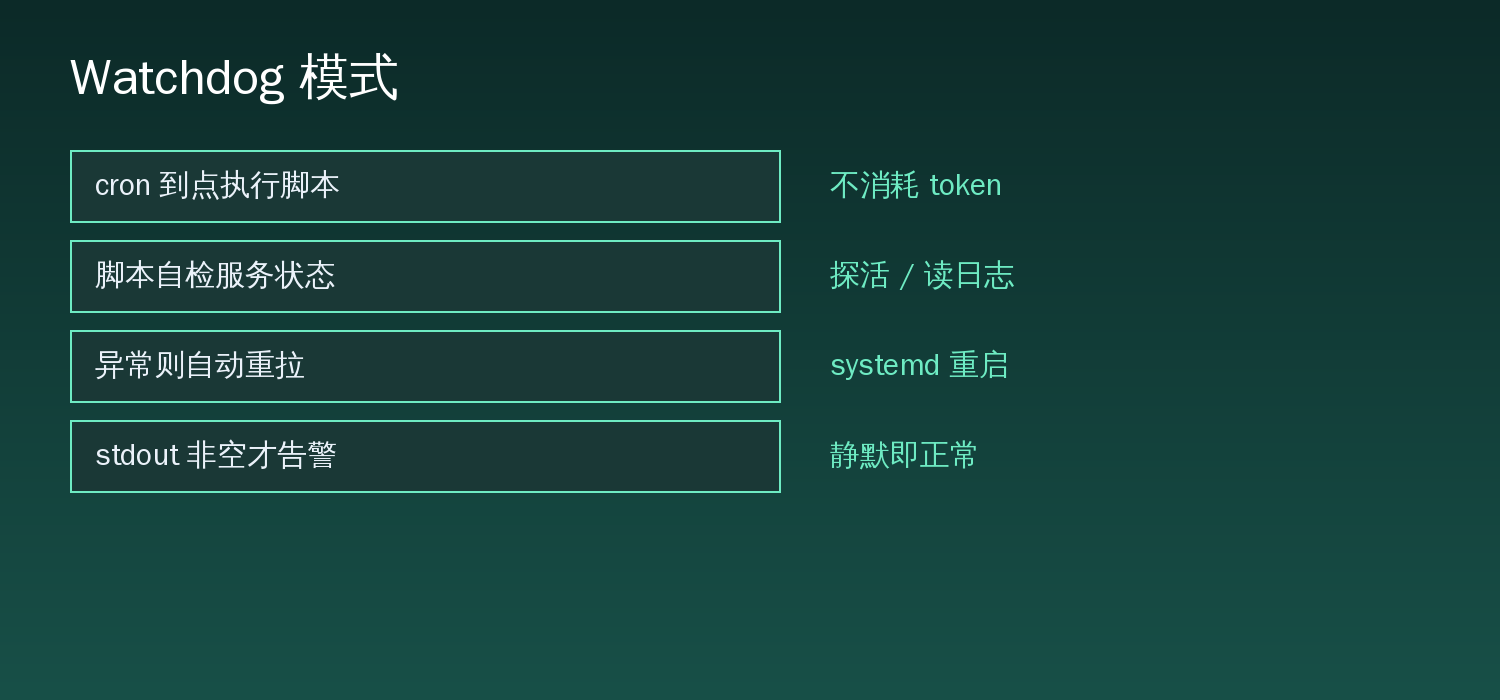
- 定时任务执行一个脚本——不经过 AI
- 脚本自己判断状态——探活、读日志、检查关键指标
- 异常时先尝试自愈——比如重启服务
- 正常时输出空内容——空输出意味着"什么都不做、什么都不发"
- 异常时才有输出——输出的内容直接推送到微信
带来的效果是:正常时完全静默,一点资源都不消耗;出问题时主动找到你,而不是等你去发现。
我在本机的落地方式是:定时任务用 no-agent 模式(跳过模型直接跑脚本),脚本正常时 stdout 为空,异常时才输出告警文本并推送。
下面是一个简化版的骨架:
#!/bin/bash
API_PORT=8899
LOG=~/.hermes/logs/health.log

log() { echo "[$(date '+%F %T')] $*" >> "$LOG"; }   # 注意:只写文件,不输出

# 探活
if curl -s -m 10 http://localhost:${API_PORT}/health | grep -q '"status":"healthy"'; then
    log "✓ 正常"
else
    log "❌ 无响应,尝试重启"
    systemctl --user restart my-service
    sleep 20
    if curl -s -m 10 http://localhost:${API_PORT}/health | grep -q healthy; then
        echo "【服务曾中断,已自动恢复】时间: $(date '+%F %T')"   # ← 有输出 = 触发告警
    else
        echo "【服务故障,自动重启失败!请人工介入】"
    fi
fi有一个细节特别关键:日志函数只写文件,不往 stdout 输出。因为 watchdog 的判断依据就是"stdout 是否为空"——如果日志也打到标准输出,那就变成永远有输出、永远告警了。
四、这套机制救过我的场
说个真实的事。
有次我重建了一个 Python 虚拟环境,重建之后某个服务依赖的一个包没有被装回去,服务静默地挂掉了。
venv 重建时间:某日 13:33
数据最后写入:某日 08:03
→ 服务从重建那一刻起就没起来过问题在于它挂得毫无声响——没有报错弹窗,没有邮件,什么都没有。我是过了大半天之后,自己想去用那个服务时才发现打不开的。
排查下来根因很清楚:环境重建导致依赖丢失。修复倒不难,重装包、起服务,几分钟的事。
真正的问题不在修复,在于"发现得太晚"。 那半天里所有依赖它的流程都在空转。
这件事之后我做了两件事:
- 把服务纳入 watchdog 监控——挂了自动重启,重启失败就告警
- 加了开机自启——不再依赖"记得手动启动"
后来我专门测了一次:手动把服务停掉,跑健康检查脚本,脚本检测到故障、自动重启、恢复服务,并把「曾中断已恢复」的告警发了出来。全程无人干预。
这就是自动化的价值——它不是让事情做得更快,而是让问题不会静默地烂在那里。
五、其他几类常用自动化
5.1 定时采集
政策、价格、公告这类有固定来源的信息,配一个定时采集任务,每天固定时间跑一遍,增量入库。
要点是做增量而非全量——只抓新增内容,避免每次重新拉取全部数据。同时要处理重复:靠 URL 或内容指纹去重,不然库里会堆一堆相同的记录。
5.2 周期报表
把数据整理成报表并发送,这件事完全可以自动跑。
踩过的坑是格式必须冻结——第一版定下来的表头、对齐方式、数据口径,后面不要轻易改。因为一旦格式变了,看报表的人会以为数据出了问题,反而增加沟通成本。
5.3 报告与文档生成
这一步才真正需要 AI 参与——把结构化数据转成可读的分析文字、把录音转成会议纪要、把素材整理成文档。
但即便在这里,也要守住一条:数据必须来自真实的取数流程,不能让 AI"根据印象"生成数字。 数字错了的报表,比没有报表更糟。
六、几条实战经验
- 静默即正常——告警要少而准。天天响的告警等于没有告警,人会自动忽略它
- 先自愈,再告警——能自动恢复的不要打扰人,只有自愈失败才需要叫醒你
- 失败不要重试不可逆操作——比如发文章、发邮件这类,重试会产生重复。区分开"可安全重试"和"绝不能重试"的操作
- 日志留痕——即使正常也要写日志,否则出问题时无法回溯"最后一次正常是什么时候"
- 定期验证监控本身有没有在工作——监控挂了而没人知道,是最危险的状况
七、小结
一个人管很多事,靠的不是更努力,而是把能交出去的事真正交出去。
这套东西搭起来的顺序建议是:
- 先找出那些"必须定期做、但结果可预期"的事——这类最适合自动化
- 写成脚本,手动跑通——不要一上来就定时
- 确认稳定后再挂定时任务
- 加上失败告警和自愈——否则自动化只是把"忘记做"变成了"静默失败"
- 把 AI 留给真正需要判断的环节
自动化的终点不是"不用干活",而是把你的注意力从"记得做"转移到"看结果"。当一件事不再需要你惦记的时候,它才算真正被交出去了。