让 AI Agent 自己发文章:发布接口的流程设计
一、起点:发文流程里最慢的一环是人
站点上的文章,"写"和"发"其实是两件事。写是创作,发是搬运——登录后台、新建文章、粘贴正文、选栏目、填摘要、传图、点发布。偶尔发一篇,这套流程完全没问题;但当文章本身就由 AI 生成、发文变成常态时,搬运就成了整条链路上最慢、也最容易出错的一环。
粘错栏目、漏填摘要、图片传了却忘记插进正文——这些都不是假设,是真实发生过的。于是有了这套接口:让 Agent 直接通过 HTTP 把文章写进 CMS,去掉中间的人工环节。
本文不是接口手册,讲的是这套流程为什么这么设计。因为面向机器的接口和面向人的接口,设计要求并不一样:人要的是提示清楚,机器要的是结果可判断、错误可自解释、操作不可逆就要能防重。
二、整体流程:四步,顺序即契约
整套流程只有四个接口,但顺序不能乱:
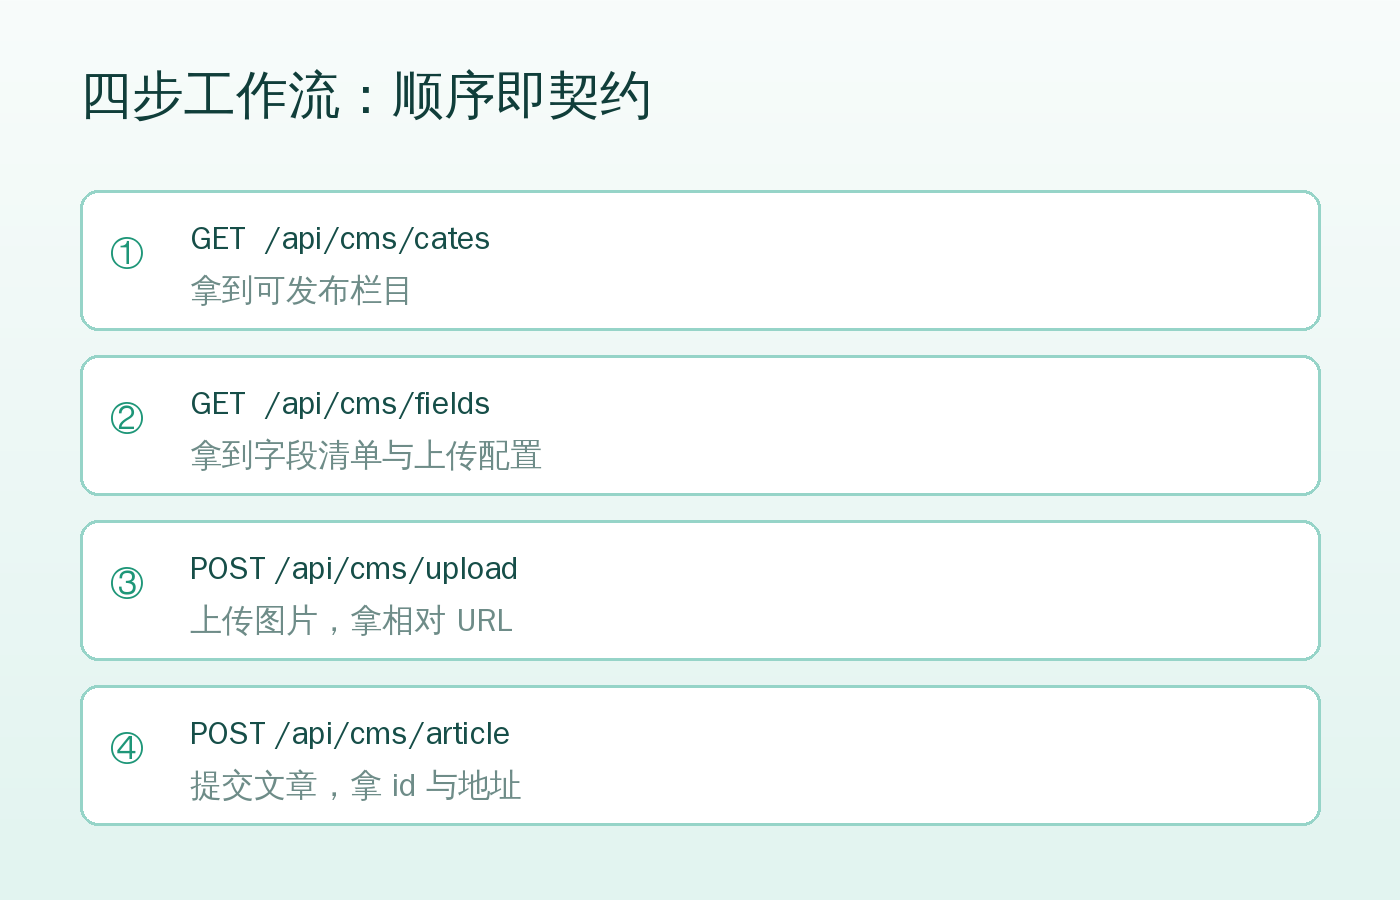
这个顺序本身就是设计的一部分:
- 先问有哪些栏目——栏目 id 不硬编码,站点新增栏目时调用方无需改代码;
- 再问该栏目要填什么字段——不同栏目字段可能不同,一切以接口返回为准;
- 然后才上传图片——正文与头图只能引用站内地址,得先拿到 URL 才能写 HTML;
- 最后提交文章——此时所有素材都已就位,提交是一次性的。
顺序对了,调用方就永远不需要"预知"站点结构。这一点对 AI Agent 尤其重要:Agent 不该靠记忆里的字段表工作,而该靠接口当下的回答工作。
三、第一步:让调用方不迷路——字段自描述
最容易被忽略、却最能决定成败的,是第二步那个字段查询接口。
GET /api/cms/fields?cate_id=17

{
  "code": 1,
  "data": {
    "cate":  {"id": 17, "cate_name": "AI学习", "cate_folder": "Ai"},
    "fields": [
      {"field": "title",  "name": "标题", "type": "text",   "required": true},
      {"field": "status", "name": "状态", "type": "radio",  "required": true},
      {"field": "image",  "name": "图片", "type": "image",  "required": false}
    ],
    "upload": {"url": "/api/cms/upload", "field_name": "file",
               "allow_ext": ["jpg", "png", "gif", "jpeg", "ico"]}
  }
}它一次性回答了三个问题:这个栏目叫什么、要填哪些字段、哪些必填、图片能传什么格式、往哪传。
为什么不能把字段表写死在调用方?因为那样一来,后台加一个字段,所有调用方都得跟着改;而后台改字段是运营日常,调用方发版不是。把"我该填什么"变成一次运行时查询,接口就永远不会和调用方脱节。
设计经验:凡是会变的东西,都不要写进调用方。让它每次开口问。
四、第三步:图片必须先落到站点
图片走独立的上传接口,单张字段名用 file,多张用 file[]:
POST /api/cms/upload
Content-Type: multipart/form-data

file=@cover.png

→ {"code": 1, "data": {
     "url": "/uploads/20260922/bb2f3583....png",
     "urls": ["/uploads/20260922/bb2f3583....png"]
}}返回的是相对路径,可以直接原样写进 image 字段和正文的 <img src>,前台会自动拼接域名——调用方不需要关心站点部署在哪个域名下。
这里有两个容易踩的点:
- 不能直接引用外站图片。把别处的图链写进正文,可能不显示或被过滤。正确做法是先下载到本地,再上传到站点,然后引用站内地址。
- 服务端会校验真实图片内容。改扩展名蒙混过关会被拦下,返回"文件不是有效的图片"。
五、第四步:正文是 HTML 片段,不是 Markdown
提交接口接收 JSON,正文以 HTML 片段原样渲染。这意味着两件事:
其一,别提交完整 HTML 文档。不要 <!DOCTYPE>、<html>、<head>、<body>,只给正文那一段。页面骨架由站点模板负责。
其二,别内联样式。不要给标签加 style 属性,也不要用 <div> 做布局——这些会与站点样式打架,轻则难看,重则破版。想让排版好看,靠语义标签:
| 标签 | 用途 |
|---|---|
<h2> | 一级小节标题(正文内不用 <h1>,页面标题已占位) |
<h3> | 二级小节标题 |
<p> / <ul> / <ol> | 段落与列表 |
<blockquote> | 引用、金句 |
<pre><code> | 多行代码块 |
<table> | 简单表格 |
还有一点:写入前要自行转义正文里的 <、>、&。文章讲代码时最容易撞上——正文里要展示一个 HTML 标签,直接写就会被浏览器当成标签吃掉。
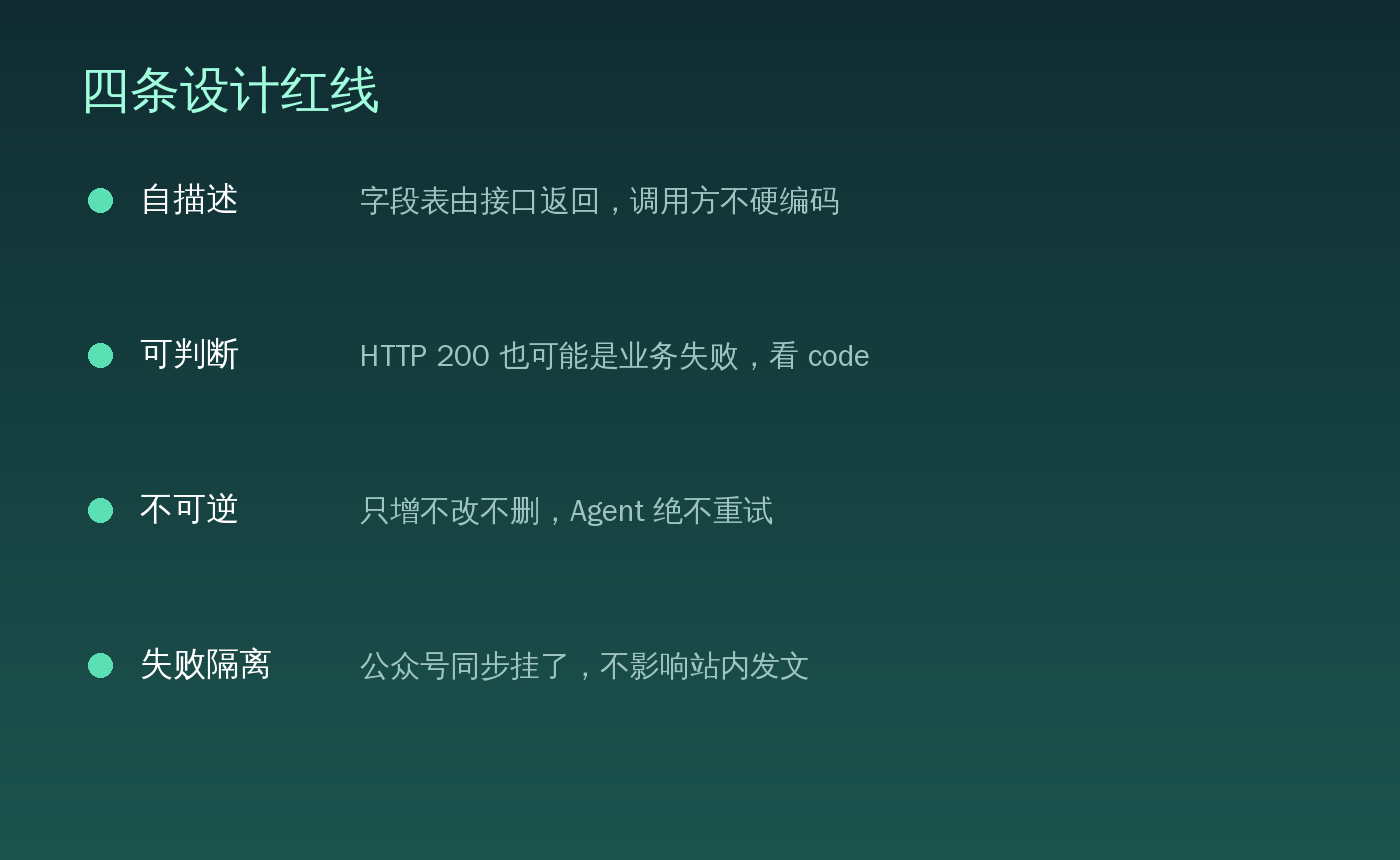
六、四条设计红线
1. 自描述:接口自己说清楚要什么
前面已展开。核心是:任何会变的信息都不该固化在调用方。栏目会变、字段会变、允许的图片格式会变——让它们都从接口来。
2. 可判断:HTTP 200 也可能是业务失败
几乎所有接口都返回 HTTP 200,业务成败体现在响应体的 code 字段:
{"code": 1, "msg": "OK",      "time": 1789718925, "data": {...}}
{"code": 0, "msg": "鉴权失败:X-Api-Token 无效", "data": []}
只看 HTTP 状态码就判断成功,是这类接口最经典的误用。 code=1 才算成功。
更进一步,失败时的 msg 要能自解释——不是抛一个"操作失败",而是明确告诉调用方错在哪:
鉴权失败:X-Api-Token 无效—— 令牌问题,检查请求头;栏目不存在:cate_id=99—— 栏目 id 错了,回到第一步重查;该栏目不支持发布文章(单页模型或非内容模型)—— 这个栏目不是文章栏目;文件不是有效的图片:a.txt—— 文件内容不对,不是改扩展名能解决的。
错误信息写得越具体,Agent 越能自己纠正。面向机器的接口,报错不是给运维看的日志,而是给调用方的操作指引。
3. 不可逆:只增不改不删,就该防重
这套接口只支持新增,不提供修改与删除。这是刻意为之:
- 文章一旦发布,URL 立即生效,可能已被搜索引擎收录、被读者转发。允许随意改删,风险大于便利;
- 更重要的是——调用方是 Agent。对不可逆操作,Agent 必须被明确告知"不要重试"。
重复提交相同标题,不会覆盖,而是新增一条。所以:POST 一旦返回成功,绝不因网络抖动而重试。
这条约束必须写进 Agent 的规则里,而不是指望它自己悟出来。
4. 失败隔离:一个环节挂了,不该拖垮全部
发布时,系统会顺带在微信公众号草稿箱建一份草稿——正文排版、图片转存、封面、阅读原文链接都会自动处理好。但这一步失败不影响站内发文:
{
  "code": 1,
  "data": {
    "id": 122,
    "url": "/index/Ai/122.html",
    "wechat": {"draft": true, "media_id": "uXgc...", "error": ""}
  }
}
即使 draft 为 false,code 仍然是 1——站内文章已经发布成功,公众号没建上只体现在 wechat.error 里。
这是多端分发时的重要原则:把"次要环节的失败"和"主要目标的成败"分开表达。如果两者混在一个状态里,一次公众号接口抖动就会让调用方以为整篇都失败了——然后重试,然后在站内多出一篇重复文章。
另外,公众号侧只能建草稿、不能自动发布(接口没有该权限),最终发布仍需人工在后台确认一次。把"最后一下"留给人,也是设计的一部分。
七、正文之外:还有一层是"内容之外"的约束
接口解决的是"怎么发",还有一层是"发什么"。
当发布权交给自动化流程后,真正需要额外守护的,是内容本身。具体的做法是:把约束明确写进调用方的规则里,而不是寄希望于模型自觉——不违法、不碰争议话题、涉及政策表述一律采用官方规范口径。这类规则写一次、长期生效,比事后删稿成本低得多。
还有一条工程上的经验:把"校验"和"发布"分成两次执行。如果把字数检查、标签规范、结构校验和最终的发布调用写进同一个脚本,那些检查就只是被打印出来,拦不住后面的提交——而接口改不了也删不了,文章只能带着瑕疵上线。凡是检查与不可逆动作同处一个脚本,检查就形同虚设。
八、小结
这套流程真正的价值,不在于省掉了多少次手动粘贴,而在于它把"发文章"从人的操作变成了可编程的动作。而要做到这一点,需要为机器重新考虑几件事:
- 会变的东西不要固化——栏目、字段、格式,都让接口现场告诉你;
- 成败要能被程序判断——HTTP 200 不算数,
code才作数; - 错误要能自解释——报错是给调用方的指引,不是给运维的日志;
- 不可逆操作要显式防重——只增不改不删的接口,必须先教会调用方"别重试";
- 失败要能隔离——次要环节挂了,不能让主流程误判为整体失败。
接口是给机器用的,但设计它的时候,想的仍然应该是人——想象调用方在半夜三点、没有任何上下文的情况下,会不会把这件事做对。