OpenClaw 卡在 2026.9.4:更新器缺陷排查
这台机器上跑着一个 OpenClaw 实例,底下挂着 10 个 agent,对接 12 个微信渠道,服务着 11 个人的日常工作。
从 2026 年 9 月底开始,这个实例一直升不上去。`openclaw update` 每次都在同一处失败,指定版本号也没用。这篇文章把那次排查完整记下来——因为最后的结论和我最初的判断完全相反。
一、现象:报错长什么样
第一次失败时,终端上留下的信息是这样:
| 字段 | 内容 |
|---|---|
| 报错原文 | Update refused: could not inspect exact package target openclaw@2026.9.6: npm view failed |
| 失败阶段 | requested(还没进入下载就退出) |
| 原因码 | plugin-target-unavailable |
| 回滚结果 | verified safe to restart(数据未受影响) |
| 当前版本 | 2026.9.4,更新前后没有变化 |
报错里那句 npm view failed 最容易被误读。它说的是"查不到这个包",而查不到包,直觉上就是网络或者镜像的问题——我一开始也是这么想的,而这是错的。
二、先排除:不是这些原因
沿着"网络/镜像"这条线,我做了几项实测:
| 怀疑方向 | 实测方法与结果 | 结论 |
|---|---|---|
| npm 源的问题 | 连续执行 8 次 npm view openclaw@2026.9.6,8 次全部成功,每次约 1 秒 | 不是源的问题 |
| 本地缓存陈旧 | 在 .npmrc 中发现 prefer-offline=true;备份后清空缓存并移除该配置 | 是一个真实隐患,但不是根因 |
| 插件包本身缺失 | 逐个核对三个插件在 npm 上的真实包名,全部存在且可查 | 不是包的问题 |
| 机器配置或网络 | 升级过程能正常下载、能进入校验阶段,网络链路通畅 | 不是环境问题 |
排除完这些之后,日志里露出了真正的线索:
Candidate doctor failed (deadline exceeded) (313094ms)
11 agent scopes need a 22000ms inspection allowance, with 0ms remaining in the validation inspection window
11 个 agent,每个需要 22000 毫秒的检查时间,加起来 242 秒,几乎等于整个校验窗口的长度。于是当时的结论是:agent 数量多、机器慢,检查超时,导致升级失败。
这个结论听上去很合理,但它同样不是根因——它只是一个伴随现象。
三、转折:官方的答复
我把这个问题提交到了 OpenClaw 的 GitHub 仓库。八分钟后,官方的自动审阅机器人给出了答复,内容如下(节选翻译):
这个插件可用性的拒绝行为,在当前主线版本上已经修复,并随 v2026.9.5 发布。机器上安装的 2026.9.4 更新器仍然包含旧的拒绝逻辑,因此需要按文档执行一次「手动首次更新」。
推荐方案:保留现有的基于警告的更新器,对 2026.9.4 的安装使用文档中的手动首次更新。
它同时给出了关联的修复记录:
| 类型 | 内容 |
|---|---|
| 主修复 | PR #145045 —— 移除 plugin-target-unavailable 这道否决,保留兼容的已装插件 |
| 后续跟进 | PR #133884 —— 把剩余的不可用替换检查由报错改为警告 |
| 相关讨论 | issue #148267 —— 讨论同一个旧版驱动拒绝问题 |
| 修复提交日期 | 2026-09-11 |
| 随哪个版本发布 | v2026.9.5(2026-09-19 发布) |
到这里根因才清晰:这是一个更新器自身的缺陷,不是环境问题。
四、真正的根因
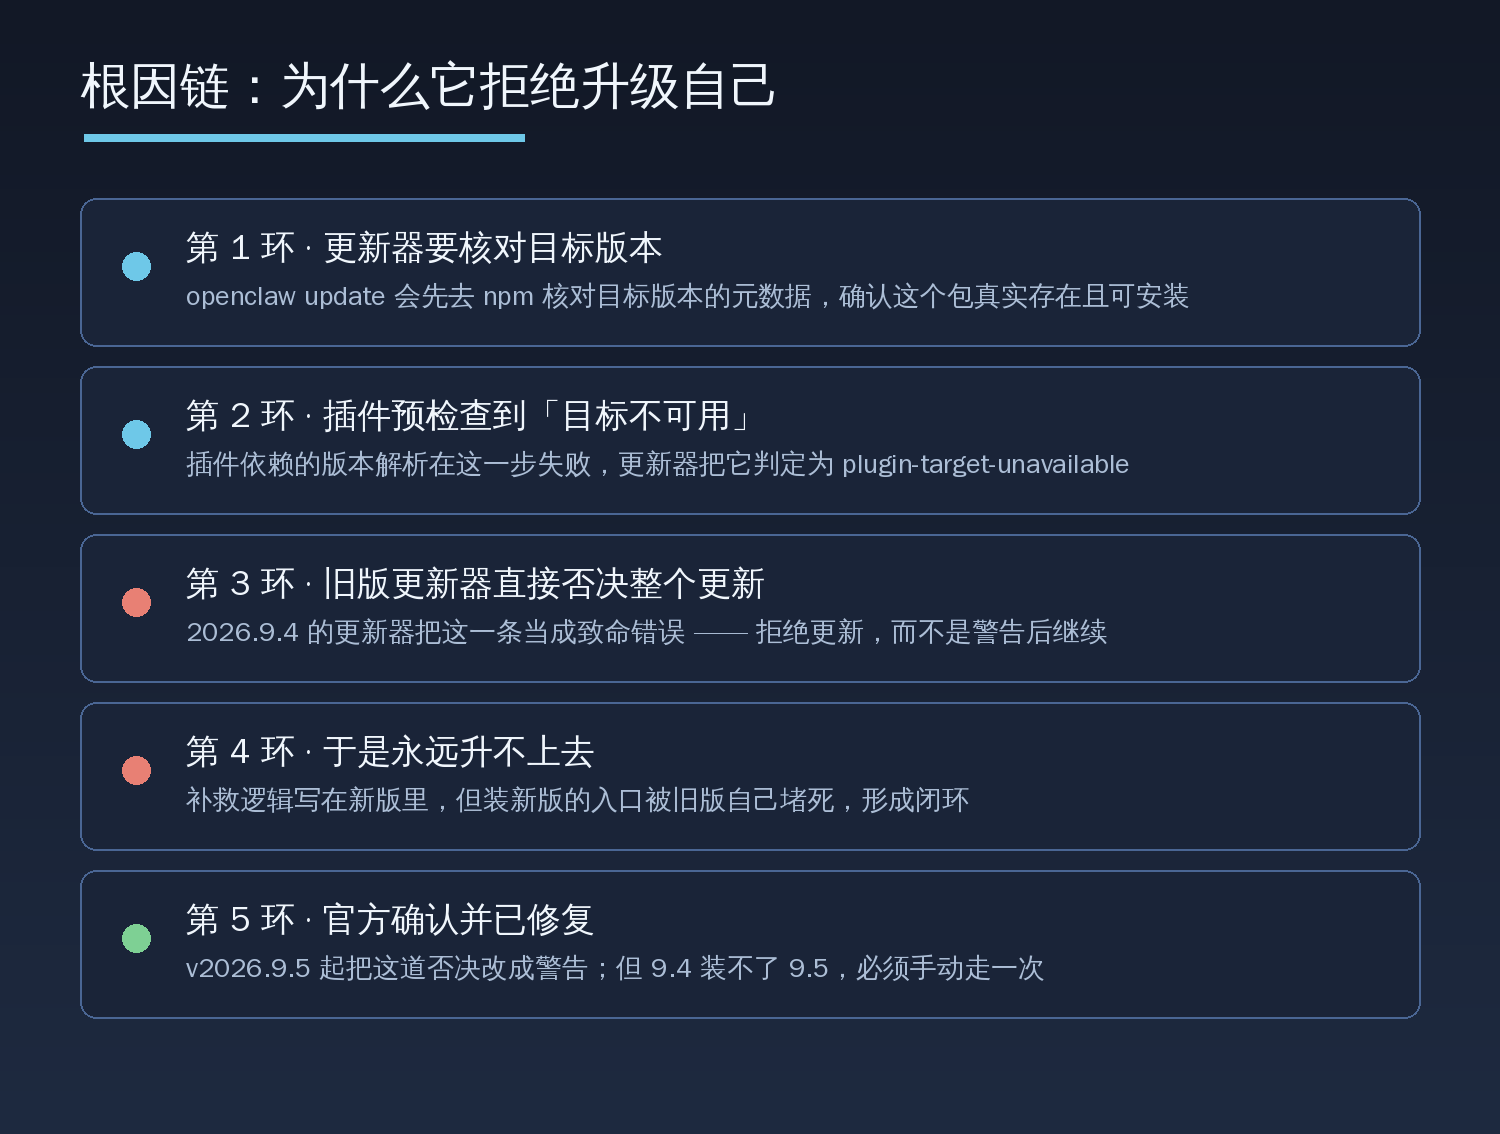
把整条链路拆开是这样的:
| 环节 | 发生了什么 |
|---|---|
| 1. 核对目标版本 | 更新器去 npm 核对目标版本的元数据,确认包存在且可安装 |
| 2. 插件预检查 | 插件依赖的版本解析在这一步没能得出结论,被判定为 plugin-target-unavailable |
| 3. 旧版的处置 | 2026.9.4 的更新器把这一条当成致命错误,直接否决整个更新,而不是警告后继续 |
| 4. 形成闭环 | 修正逻辑写在新版里,但安装新版的入口被旧版自己堵死 |
| 5. 官方修复 | v2026.9.5 起把这道否决改成警告;但 9.4 装不上 9.5,必须手动走一次 |
一个用于升级的工具,因为自身的一处判断失误,拒绝了升级自己。这类闭环在自动更新系统里并不罕见,它通常需要一个「手动介入」的出口。
五、解法:手动首次更新
官方给出的方案只有一句话:使用文档中的手动首次更新。展开就是——跳过那个坏掉的更新器,直接用包管理器装一次目标版本。
选版本时有一个必须考虑的因素:schema 版本。OpenClaw 的状态数据库有独立的 schema 编号,升级跨版本时可能需要迁移;如果新版要求的 schema 高于当前所用版本,直接装上去会读不了数据。
| 版本 | 对应 schema | 相对 2026.9.4 的变化 |
|---|---|---|
| 2026.9.4(当前) | 17 | — |
| 2026.9.5 | 17 | 不迁移,风险最低 |
| 2026.9.6 | 18 | 需要一次迁移 |
| 2026.9.7 及以后 | 19 | 需要一次迁移 |
从稳妥角度,9.5 是最省事的一跳——同样的 schema,装上就能用。但因为它修复的正是更新器本身,装上 9.5 之后,后续版本就可以用正常的 openclaw update 来完成了。
六、实际执行流程
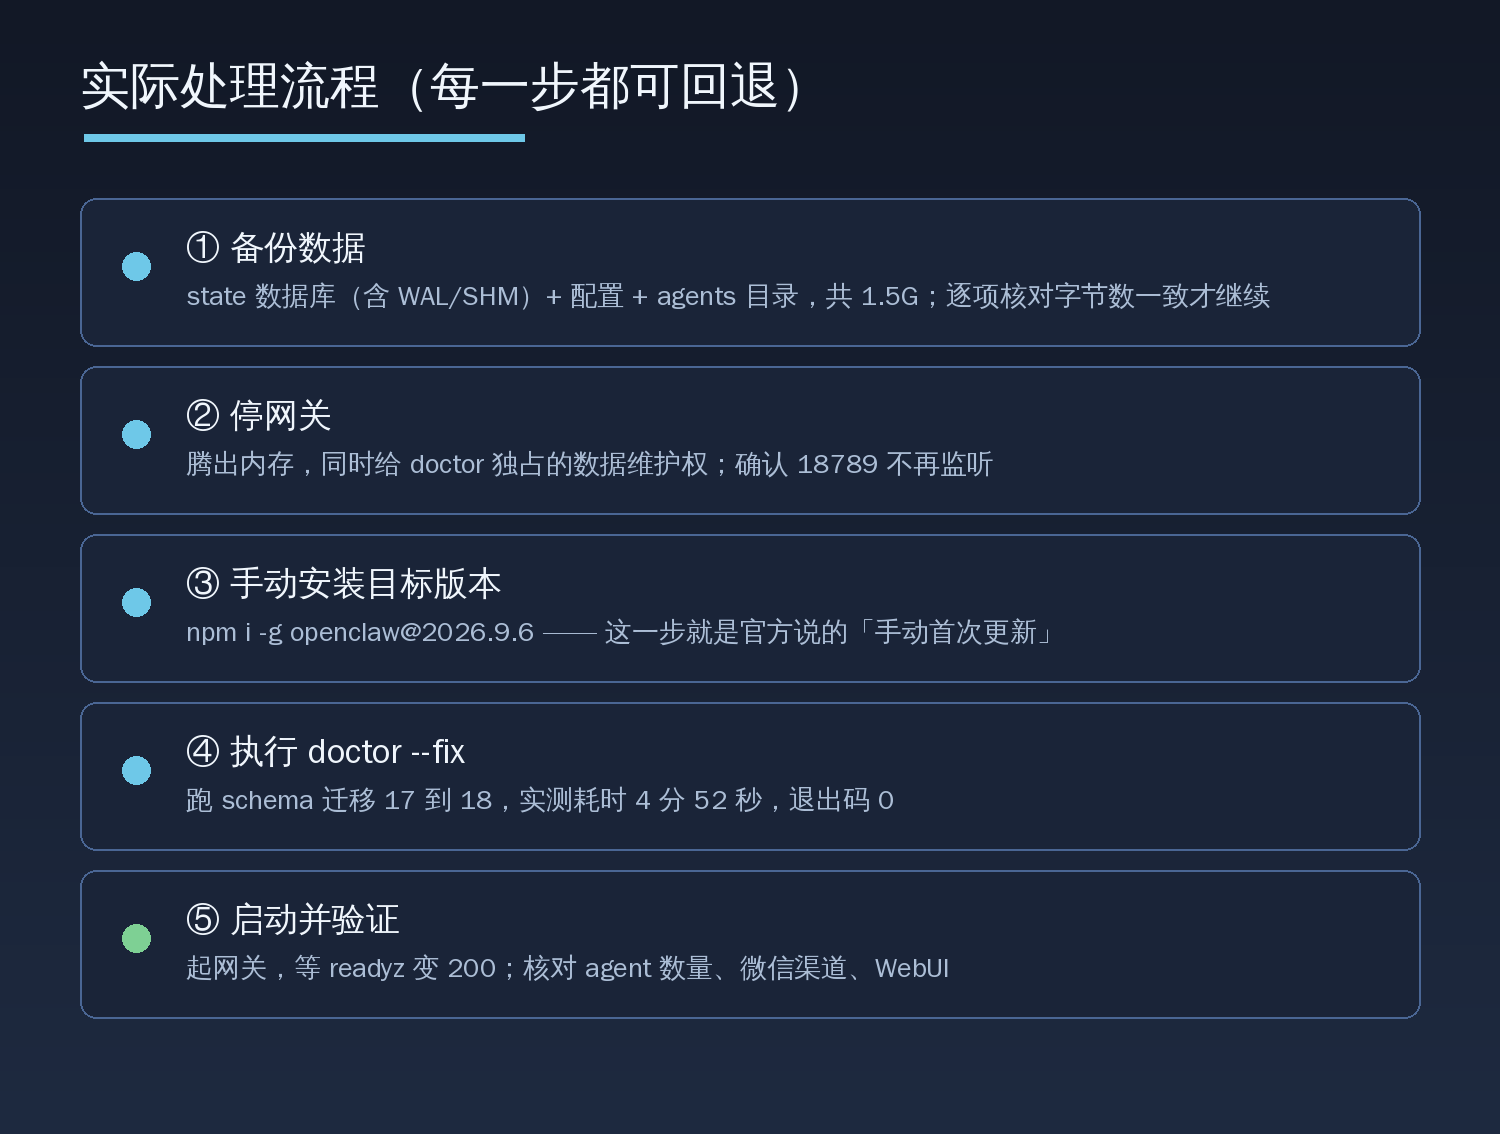
整个流程的原则是每一步都可回退。
① 备份数据(最重要的一步)
在动任何东西之前,先把数据完整复制一份。这一步不能省——后面要做 schema 迁移,一旦迁移失败且没有备份,就没有退路。
| 备份对象 | 大小 | 为什么必须备 |
|---|---|---|
| state 数据库(含 WAL / SHM) | 28.8 MB | schema 迁移直接改的就是它 |
| openclaw.json | 16 KB | 十个 agent 与全部路由配置 |
| agents 目录 | 1.4 GB | 每个 agent 的工作区与会话数据 |
备份完成后务必核对字节数,不要只看"命令执行成功"。停服时数据库可能还有未落盘的 WAL 文件,连同它一起复制才算完整。
② 停网关
腾出内存,同时把数据维护权让给 doctor 独占。停服时要确认端口不再监听,而不是只看命令返回。
停服过程中会出现 shutdown timed out; exiting without full cleanup 以及进程被 KILL 的记录。这是优雅停机遇到未排空任务时的正常表现,不是崩溃——但它意味着 WAL 可能没有正常落盘,这也是第一步必须把 WAL 一起备份的原因。
③ 手动安装目标版本
跳过坏掉的更新器,直接用包管理器安装:
npm i -g openclaw@2026.9.6
装程序不会碰数据。程序装在全局 node 目录下,配置与会话都在用户目录里,两者是分开的。
④ 执行 schema 迁移
openclaw doctor --fix
这一步跑 schema 迁移。本次实测耗时 4 分 52 秒,退出码 0——迁移成功。耗时的主要来源是每个 agent 的数据完整性检查,在这台机器上每个约 22 秒。
⑤ 启动并验证
起网关之后不要立刻下结论,要等就绪探针返回成功。本次启动时 readyz 先返回 503,约 20 秒后才转为 200——这是正常的加载过程。
七、结果
| 检查项 | 结果 |
|---|---|
| 版本 | 2026.9.4 → 2026.9.6 |
| schema | 17 → 18,迁移成功 |
| doctor 退出码 | 0 |
| 网关服务 | active |
| 就绪探针 | readyz = 200 |
| agent 数量 | 10 个,全部加载 |
| 微信渠道 | 12 个实例全部恢复 |
| WebUI | 正常访问 |
| 数据完整性 | 备份与源文件字节数一致,迁移后全部正常 |
迁移从 16:11:05 开始,到 16:15:57 结束,整段停机时间控制在可接受范围内。
八、几条经验
| 经验 | 说明 |
|---|---|
| 报错文案会误导排查方向 | 「npm view failed」看起来像网络问题,实际是更新器自身逻辑拒绝;先在源码里找这句话的出处,比顺着字面意思猜更快 |
| 伴随现象不等于根因 | 「检查超时」真实存在,但它只是现象;真正的否决发生得更早 |
| 自动更新系统需要手动出口 | 当更新器本身出问题时,必须有办法绕过它——否则旧版本永远升不上来 |
| 查官方 issue 比继续自测更快 | 提交后八分钟就拿到了结论与修复版本号;此前自己做的几轮实测虽然有用,但得不出这个结论 |
| 迁移前必须备份,且要核对 | 核对字节数,别只看命令是否成功;把 WAL 一起复制 |
| 选版本先看 schema | 跨越 schema 的版本会触发数据迁移,同 schema 的升级风险最低 |
| 就绪探针要等,不能立刻下结论 | 启动后 readyz 短暂返回 503 是正常的,等它转 200 再验证 |
写在最后
这次排查最大的收获不是修好了升级,而是认识到第一直觉往往来自报错的字面意思,而报错文案是程序写的,不是事实写的。
「查不到包」和「不让升级」是两回事。前者指向网络,后者指向逻辑。当我一直沿着网络那条线查下去时,每一步都"有结果",但每一步都在远离真正的问题。
真正让这件事结案的,是把问题提交给官方。八分钟,一个版本号,一条明确的路径。