纳米之后往哪走:关于进制、架构和「推倒重来」的辨析
前几天有人聊到一个问题:CPU、GPU 的制程一路往几纳米以下推,可电学的特性摆在那儿,这条路总有尽头。既然快到头了,是不是该换个方向——比如让加载更快、算得更快,那是不是连并发处理都不需要了?再往下想,大模型那么依赖显存,是不是说明底层的结构设计从一开始就偏了?
还有人问得更彻底:既然最早选了二进制来存储和计算,那能不能干脆换成三进制、甚至更高的进制?那样一来,存储空间和计算能力是不是就成倍往上涨了?
这些问题问得挺到位,但里面掺着几个常见误解。我把它们拆开逐条说,哪些方向是对的、哪些推算站不住脚,尽量讲清楚依据。
一、「几纳米」这个数字,早就不代表物理尺寸了
先纠正一个前提:「制程数字越来越小,说明我们一直在缩小晶体管」——这个印象在 1990 年代基本成立,但今天已经不是这样了。
在 1990 年之前,栅极长度的减小几乎是线性的。每一代晶体管的长和宽都是上一代的 0.7 倍(0.7 × 0.7 = 0.49),面积缩到原来的一半,恰好对应摩尔定律「密度翻倍」的描述。那个时期,「Xnm」里的 X 指的就是芯片栅极的长度——源极到漏极的距离。数字越小,性能越强,直观且诚实。
但之后情况变了。场效应晶体管脱离了原本固定的平面结构,FinFET 出现后,沟道变成三维环绕,沟道长度逐渐不能代表工艺的最高精度。于是7nm、5nm、3nm 不再是沟道长度,而是一个「等效节点」——一个数字而已。
台积电的研究副总裁 Philip Wong 在 Hot Chips 31 上说过一句很直白的话:现在「Xnm」代表的只是技术的迭代,就像车型号一样不具有明确的意义。这也是英特尔后来改用 Intel 7、Intel 4、Intel 3、Intel 20A、Intel 18A 这套命名,重新定义自家制程的原因。
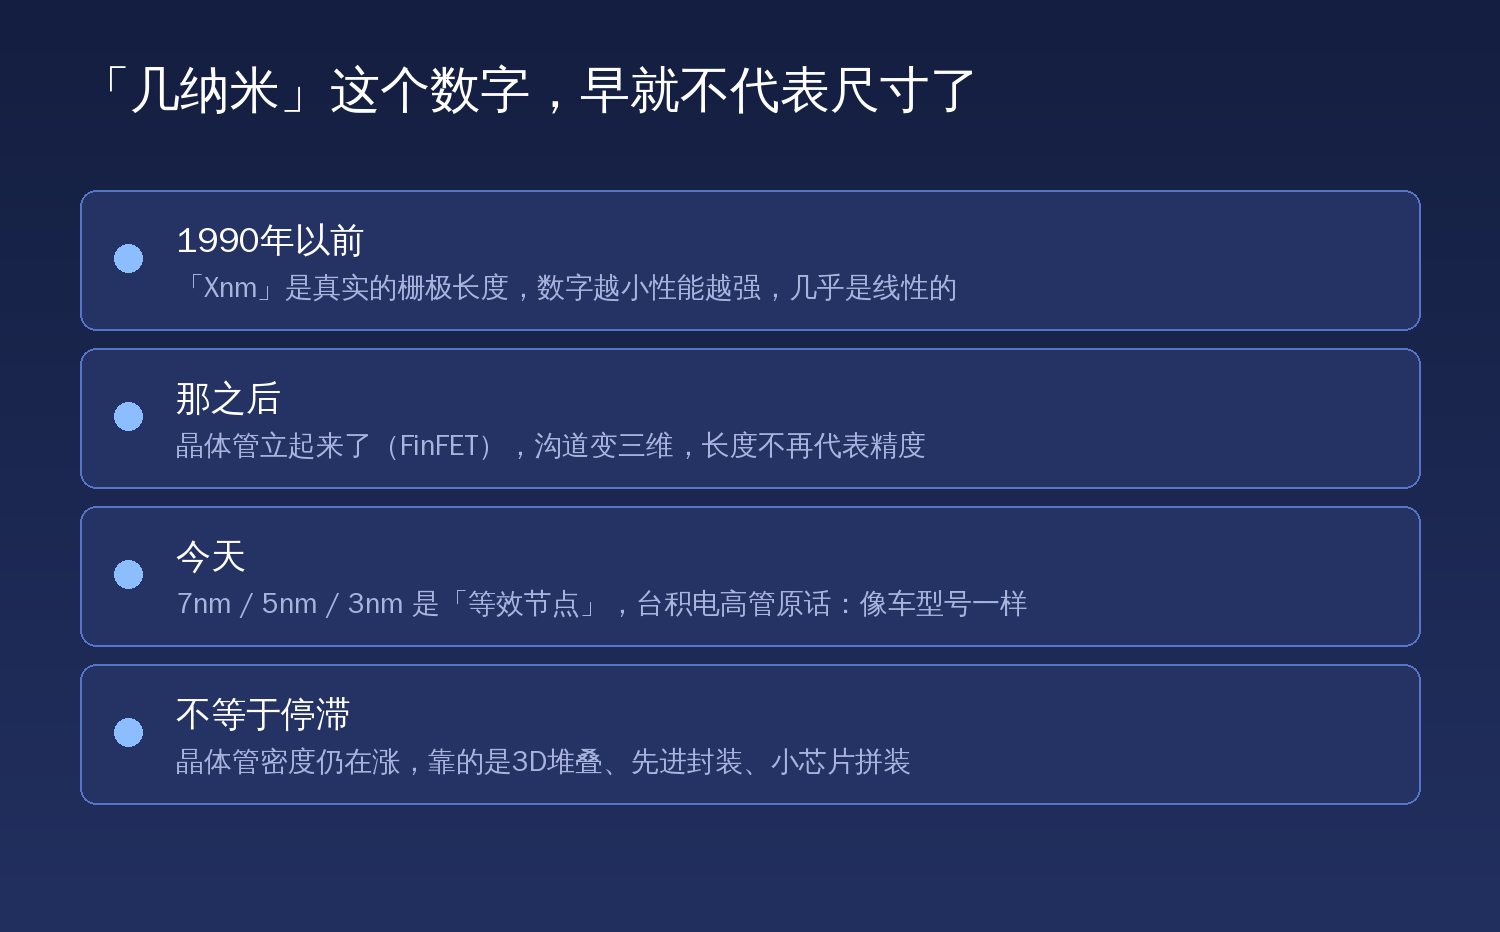
但要说清楚:这不等于技术进步停滞了。晶体管密度仍在增长,只是增长的方式换了——从「把单个晶体管做小」变成「3D 堆叠、先进封装、小芯片拼装」。
真正逼近物理极限的是另一回事:开关尺寸越小,为了通过更大的电流,关闭状态下的泄漏电流就越多,这部分功耗不可控,直接取决于工艺稳定性。良率因此成为比制程数字更硬的指标——5nm 时期三星代工的部分芯片良率据报只有 35% 左右,而一种成熟工艺的良率通常在 90% 以上。
所以「快到尽头」这个判断方向是对的,但它指的是「靠缩小尺寸换取性能」这条路快到尽头,不是整个半导体行业快到尽头。
二、「算得更快就不用并发了」——这个推断不成立
这是个需要拆开的推论。
并发处理解决的从来不是「算得慢」的问题,而是「同时有很多件事要做」的问题。哪怕单核速度无限快,一台服务器仍然要同时响应一万个用户的请求——这不是靠算得快能解决的,靠的是并行。
换句话说:单任务变快和同时处理多任务,是两个维度的事。前者靠制程和架构,后者靠并发模型。快十倍不会让并发需求消失,只会让每个并发单元处理得更快。
但这个问题里有一半是对的:「让加载更快」确实是个真方向。只是它指向的不是「消灭并发」,而是另一个更根本的瓶颈——内存墙。
三、大模型为什么吃显存:不是装不下,是喂不饱
「大模型依赖显存」这个观察是对的,但原因值得说清楚——问题主要不是容量不够,而是带宽不够。
当处理器的运算成长速度明显快于内存带宽和传输能力的成长速度时,大量时间并不是花在运算本身,而是耗费在等待数据从内存里搬过来。当系统性能受制于数据传输速度,就形成了典型的「内存墙」(Memory Wall)。
大语言模型恰好是最典型的受害者。Transformer 架构下,权重参数和推理过程中的 KV 缓存都需要在 token 生成阶段反复读取。每生成一个 token,几乎都要把海量参数从显存里搬一遍。
有一个更直观的数字能说明问题:在冯·诺依曼架构下,数据搬运的能耗占比超过 60%。也就是说,大部分能量不是花在「算」上,而是花在「搬」上。
所以判断一块 AI 芯片,看显存带宽往往比看算力峰值更有意义。HBM 之所以成为关键词,原因就在这里。
四、「底层结构偏了」——偏在哪,为什么不推倒重来
这个判断我认为是成立的:存储与计算在物理上分离,今天确实成了根本性的瓶颈。
但要修正一处归因。有人说这套结构「当初是为了分工开发电脑各个配件」才这么设计的——这个说法不太准确。
存储与计算分离出自冯·诺依曼架构,它是为了解决「通用计算」这个问题而设计的:把指令和数据放进同一个存储器,机器就能通过更换程序完成不同任务。这在 1945 年是个巨大的进步,模块化是它带来的结果,不是它被设计出来的原因。
真正让问题加剧的是另一件事:处理器和存储器长期以来走的是两条不同的工艺路线,各自按自己的节奏优化,于是两者之间的性能差距越拉越大——这才有了「存储墙」和「功耗墙」。
那为什么不推倒重来?
因为不是没人推,而是推了没有生态。历史上每一次试图绕开现有体系的尝试,技术上都未必差,但都面临同一个问题:几十年的软件栈、工具链、人才储备、产业配套,全部建立在现有架构之上。换架构意味着这些全部作废。
后面讲的三进制计算机,就是这个规律最典型的案例。
五、三进制:真的造出来过,而且赢了一阵子
「能不能不用二进制」这个问题,答案是:用过,而且效果不差。
1958 年,苏联莫斯科国立大学的计算机研究中心研制出世界上第一台三进制电子计算机,名叫 Сетунь(Setun)。
它用的还不是普通的三进制,而是平衡三进制(对称三进制)——由 −1、0、1 构成,对应逻辑电路上的负电压、零电压和正电压。这个设计很巧妙:由于 −1 的引入,记录负数时不必再加一个负号,而二进制是无符号数,不能直接表示负数。
这台机器的实际表现相当好:不同室温下都表现出惊人的可靠性和稳定性;售价只有 27.5 万卢布,创造了当时的最低记录,而同期计算机售价基本是它的两倍以上;那台放在莫大计算中心的样机整整运行了 17 年,除了第一年更换过三个缺陷元器件,内部设备从未维修过。
1959 年起,苏联部长会议通过了批量生产决议,前后共生产了约 50 台。1970 年又推出了 Setun 70,还对应二进制的 byte 创造了三进制字节 tryte——每个 tryte 由 6 个 trit 构成,约等于 9.5 个二进制 bit。
但它最终停产了。1965 年,主管的工业部叫停了生产,拒绝订单,也没有随市场需求增加产量。
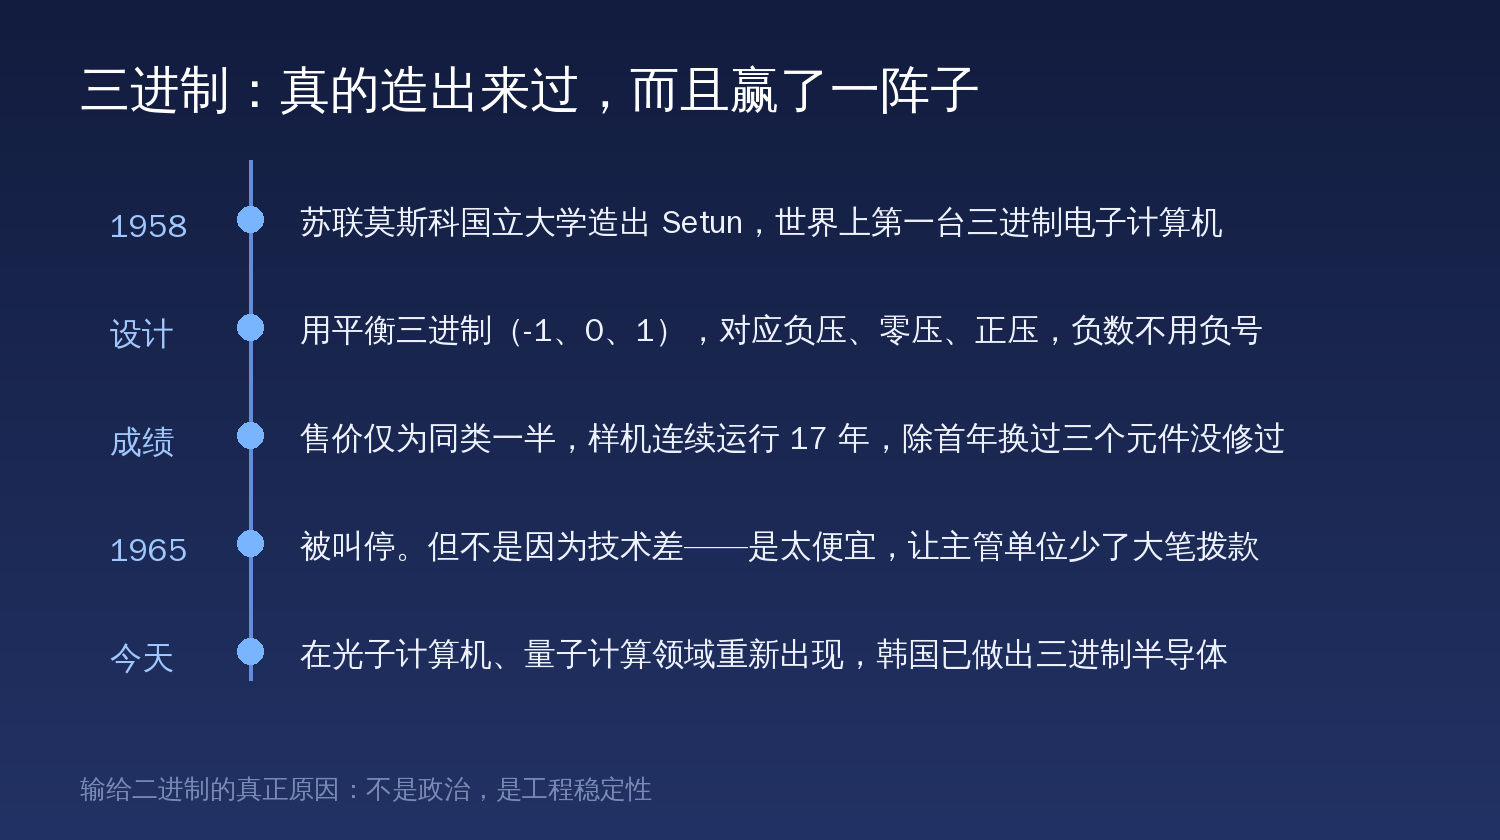
停产的原因值得琢磨——恰恰是因为它太好了。它的元器件良品率极高、非常耐造、价格还很低。可以说,Setun 的生产让主管单位少了大笔财政拨款。这才是它被叫停的直接原因。
但更值得注意的是:政治原因并不是它最终失败的主要原因。三进制输给二进制,某种程度上是一种历史必然,而原因在工程上。
输在工程稳定性,不是输在政治
要把三进制做成计算机,需要三种稳定状态的材料——基本的二极管就不够用了。
而二进制只有 0 和 1,高低电压很好区分,就算有些误差,计算机也能识别出来,所以稳定性远远高于三进制,工程上也更容易实现。
换句话说:三进制的效率优势停留在数学层面,而从数学到工程实现之间,隔着太多步骤。为了那一点可能的好处,从头重建一整套技术体系,性价比并不划算。而与此同时,二进制的发展速度早已快得没影了。
六、那「几何倍增加」成立吗——不成立
回到最核心的那个问题:换成三进制,存储空间和计算能力是不是成倍增长?
先看信息论上的上限。一个二进制符号携带的信息量是 log₂2 = 1 bit,一个三进制符号是 log₂3 ≈ 1.585 bit。所以理论上限大约是 58.5% 的提升,不是几何级。
而且效率的定义如果换成「表示相同信息量需要多少元件」,结论会更不利于这个猜测。数学上效率最高的进制其实是 e 进制(e ≈ 2.718)——三进制比二进制更接近 e,从这个角度看确实更优,但优势非常有限。
更说明问题的是:在「用最少的牌子表示 0 到 999」这个经典例子里,二进制和四进制的效率是并列最高的,三进制反而不占优。所以「进制越高越好」并不成立,最优解是 e 附近的一个整数,而 2 和 3 都在附近。
更关键的:「多进制」其实早就在用了
这是我认为最能说明问题的一点——多进制不是没人试过,而是用在了该用的地方。
看看今天的闪存:
- SLC——每个存储单元记录 1 bit
- MLC——每个存储单元记录 2 bit
- TLC——每个存储单元记录 3 bit
- QLC——每个存储单元记录 4 bit
一个存储单元里存 3 bit、4 bit,这在本质上就是「多进制」。它早就批量商用了,你的手机、固态硬盘里到处都是。
那为什么这套做法只用在存储上,没用在计算逻辑上?因为容错成本不同。
存储单元区分 16 个电平来存 4 bit,出错没关系——读慢一点、加纠错码、定期刷新,都能补救。但计算逻辑一旦在某个状态上判错,整个结果就是错的,没法靠「慢一点」挽回。所以存储可以容忍多进制带来的信噪比下降,计算不行。
结论:把三进制搬到 CPU 上,理论收益约 58.5%,而工程上要付出的稳定性代价可能远超这个数字——这是一笔不划算的账。
七、真正在推进的方向,不在进制上
那么「换个方向」这个想法错了吗?没错,只是换的方向不是进制,而是更底层的那件事——计算和存储的关系。
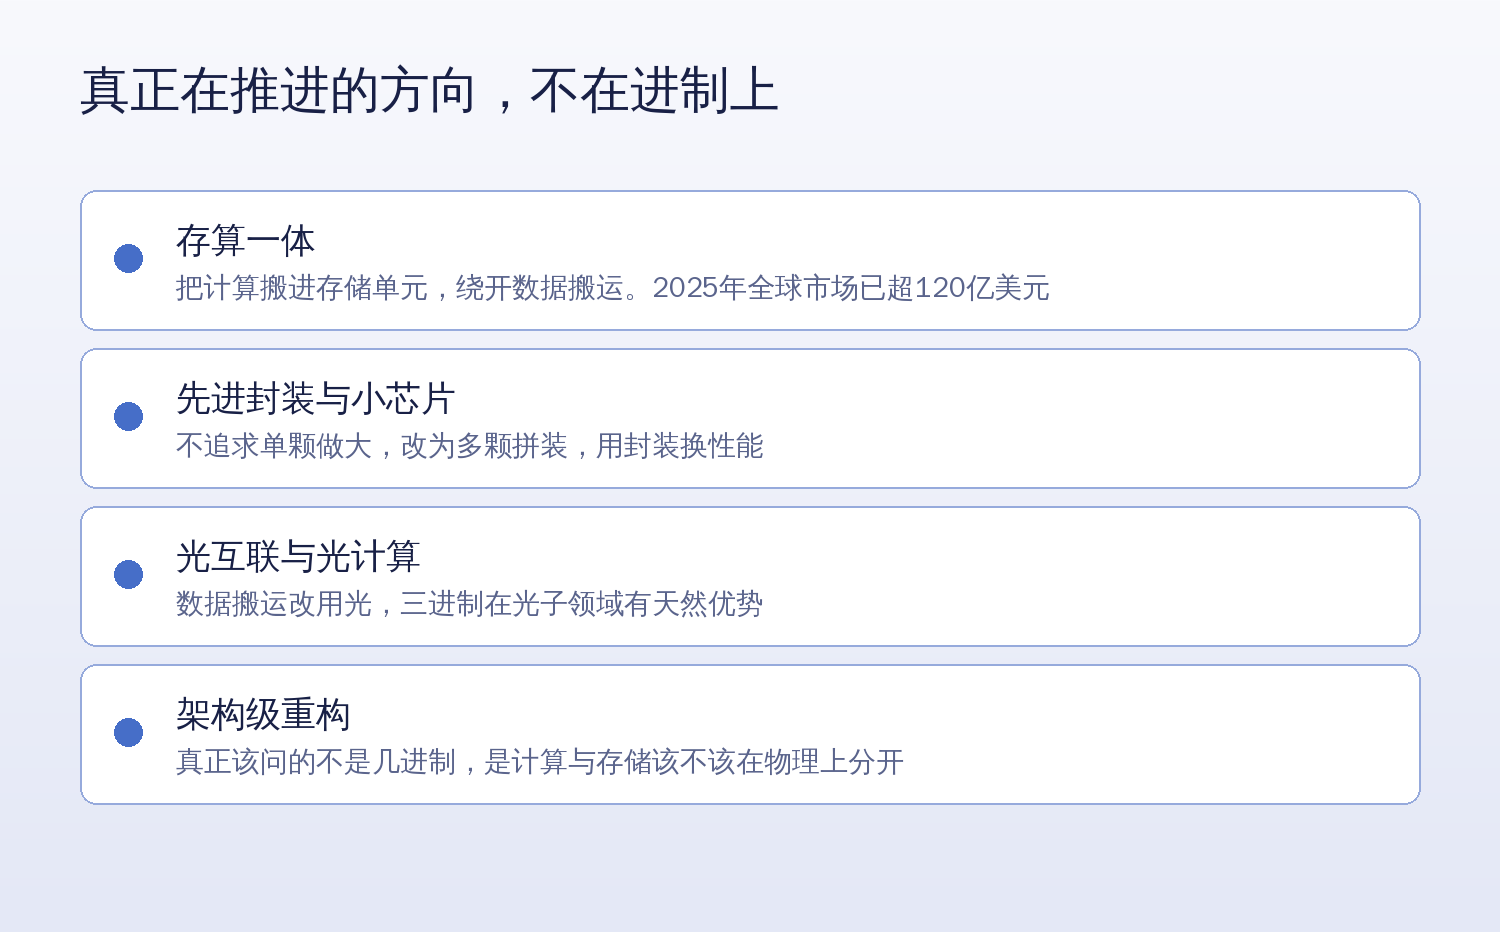
存算一体
把计算直接搬进存储单元里做,从物理上绕开「把数据搬来搬去」这个环节。技术路径主要分三支:近存计算(PNM)、存内处理(PIM)、存内计算(CIM)。
这不是实验室里的概念了:2025 年全球存算一体芯片市场规模预计突破 120 亿美元,中国占比约 30%;到 2026 年,这个产业已经从概念验证迈入商业化试点。
这条路线解决的,恰恰是前面说的那个「数据搬运能耗超过 60%」的问题。
先进封装与小芯片
不再追求把单颗芯片做大,而是把多颗功能不同的芯片拼装在一起,用封装换性能。这是「制程数字不再有意义」之后,业界给出的主要解法之一。
光互联与光计算
数据搬运改用光来做。有意思的是,三进制在光计算领域反而有了天然优势:电子计算机只有开关两种基础状态,而光子本身就有光强、波长、相位、传播方向和偏振等多种可用的物理状态。
上海大学金翊教授团队就曾取「有无光态」和「偏振方向正交」这三个物理状态,尝试光子计算机。三进制并没有死,只是在电子计算机上不合适,换到别的物理载体上又重新出现了。
量子计算
2019 年,我国物理学家郭光灿院士和中国科技大学的同事成功完成了三进制 qutrit 量子信号的传输,这是量子领域第一次成功的三进制研究。近几年韩国也开发出了三进制半导体。
八、回到最初那个问题
把整件事收一下。
「几纳米快到尽头」——方向对。但准确的表述是:靠缩小尺寸换性能这条路快到尽头,晶体管密度的增长正在改用堆叠和封装的方式延续。
「算得更快就不用并发」——不成立。并发解决的是同时处理多任务,和单任务快慢是两个维度。但「加载更快」这个直觉指向了一个真问题:内存墙。
「大模型依赖显存」——对,但原因是带宽不是容量。数据搬运的能耗占比超过 60%,这才是要害。
「底层结构偏了」——对。冯·诺依曼架构的存储与计算分离,在 AI 时代确实成了系统性瓶颈。但要修正归因:它当初是为通用计算设计的,不是为了分工开发配件。而它难以被替换的原因是生态,不是没人尝试。
「换成三进制能不能成倍提升」——不成立。理论上限约 58.5%,而且「多进制」早已在闪存上商用(TLC 每单元 3 bit、QLC 每单元 4 bit)。它之所以只用在存储而不用于计算,是因为计算容不下那个容错成本。
如果只记一句话,我建议记这句:
真正该问的不是「用几进制」,而是「计算和存储该不该在物理上分开」。
进制只是表达方式,它在数学上早就接近最优了;而存储与计算之间的那道墙,才是今天真正卡住算力的地方。存算一体、先进封装、光计算——现在推进得最实的几条路线,全都是在拆这堵墙,而不是在改数字的进制。