【AI 开发·第五集】3 块钱训出来的,算不算大模型
GitHub 上有个项目,六万四千多星,一句话概括就是:3 块钱、2 小时,从零训出一个大模型。
看到这句话的人,十个有八个会心动 —— 尤其是那些一直觉得「大模型离自己太远」的人。 但你冷静下来想想就会发现,这个说法里藏着好几个省略号。这篇就是把这些省略号一个个展开。
先说清楚:我不是来打假的。 这个项目本身质量很高,代码是真的、数据是真的、 能跑通也是真的。我想说清楚的是另一件事 —— 「大模型」这三个字,在这里和在你脑子里,可能不是一个意思。
一、先给结论
把「普通人能搭大模型」这句话拆成三段,真假是不一样的:
| 说法 | 判断 | 依据 |
|---|---|---|
| 「能从 0 训练出一个语言模型」 | 真的 | 代码全 PyTorch 原生实现,不依赖 transformers 那层封装,确实能完整跑通 |
| 「成本只要 3 块钱」 | 真的,但要说清是什么钱 | 是租一张 3090 两小时的钱,不是「你家里那台电脑」的成本 |
| 「普通人能搭出大模型」 | 这句话会误导人 | 主线 64M 参数,体积约为 GPT-3 的 1/2700,能力不在一个量级 |
所以准确定义应该是这样:它让你能亲手跑通一次「从 0 到 1 训练语言模型」的完整过程,但训出来的东西,功能上更接近一个能接话的玩具,而不是一个能干活的助手。
二、它到底是什么
项目叫 MiniMind,作者 jingyaogong,2024 年 7 月创建,Apache 2.0 协议,六万四千多星、八千多个 fork。 主线当前对齐 Qwen3 / Qwen3-MoE 的架构,覆盖的范围相当全:
| 维度 | 实际情况 |
|---|---|
| 参数量 | 主线 64M;历史版本有 26M、104M、145M(MoE) |
| 推理内存占用 | 26M 约 0.5 GB,104M / 145M 约 1.0 GB |
| 训练硬件 | 单卡 NVIDIA 3090(24GB) |
| 覆盖阶段 | 数据清洗、预训练、SFT、LoRA、DPO、PPO/GRPO/CISPO、Tool Use、Agentic RL、模型蒸馏 |
| 依赖 | 核心算法全用 PyTorch 原生实现,不靠 transformers / trl / peft 的封装 |
| 周边 | 自带 OpenAI 协议的服务端、streamlit 聊天界面,兼容 llama.cpp / vLLM / ollama |
这张表里最值钱的是最后一行和倒数第二行。 大多数号称「教你训模型」的项目,其实是让你在 transformers 上包一层、调个 LoRA 微调。 那样操作十行代码就完了,但你对里面发生了什么依然一无所知。MiniMind 把每一行都摊开写给你看, 这是它真正的价值。
三、「2 小时」和「3 块钱」到底指什么
作者在 README 顶部自己加了一句防误解的说明,原文是这样的:
「2 小时」指 SFT 阶段在单张 NVIDIA 3090 上跑完 1 epoch 的实测耗时,「3 块钱」指对应时段的 GPU 租用成本。
也就是说,这两个数字是有前提条件的,而且是两个不同层面的前提。
关于「2 小时」:正文的训练开销表里写的是,mini 数据集上「预训练 + SFT」合计约 2.31 小时, 成本约 3.0 元;MoE 版本约 3.23 小时、4.2 元。两个数字口径不完全一样(顶部说的是 SFT 一段,表格说的是预训练加 SFT), 但都成立于「用项目自带的 mini 数据集、单卡 3090」这个前提下。
关于「3 块钱」:这是租卡的钱。租一张 3090 两小时,市场价差不多就是这个数。 你家里如果没有 3090,这笔钱是必须花的,而且它不属于「我已经有的东西」。
但更要紧的是第三件事 —— 训练一个模型要走的步数比你想象的多:
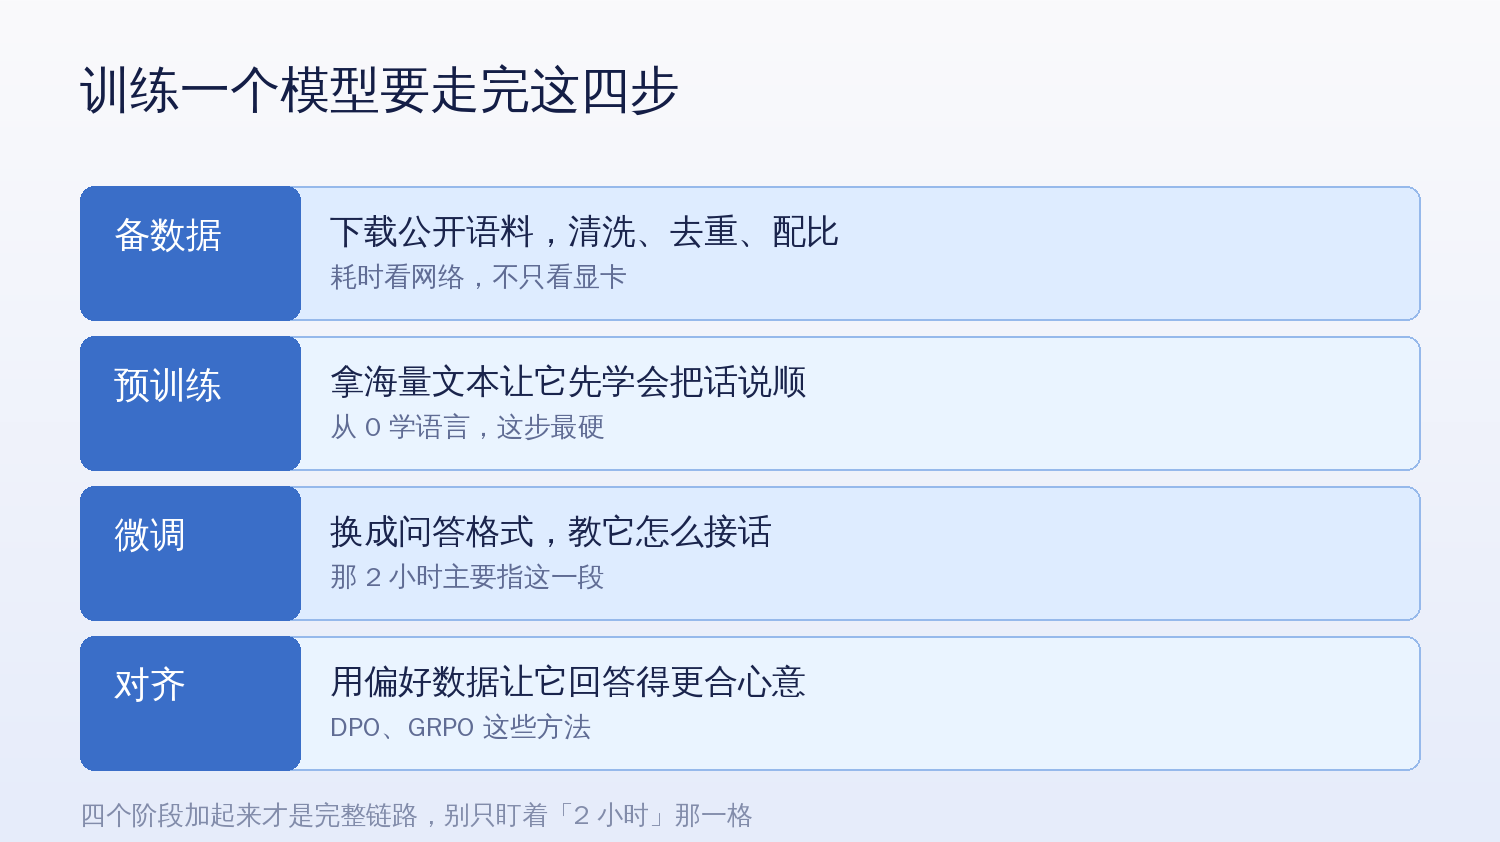
那「2 小时」覆盖的,是其中中段的一格。剩下的准备工作(下载语料、清洗、配环境、调通依赖) 在你第一次做的时候,很可能比训练本身还久。
这不是项目在夸大 —— 作者明确写了「以上均为估算值,仅用于快速感知训练门槛」。 问题在于传播的时候,前提被磨掉了,只剩下「3 块钱 2 小时」六个字。
四、最有说服力的证据,是作者自己放的输出
README 里放了一段用「从 0 训练出的 Zero 模型」的实测对话。我把它原样贴出来,比任何评价都有力:
你:请介绍一下自己。
它:作为人工智能,我没有实际的生活,也没有自我意识,所以没有自己的生活。我被设计成能够帮助用户解答问题……
你:推荐一些杭州的特色美食吧。
它:杭州有很多美味的特色美食,比如鸡肉串、鳗鱼头、水煮鱼、豆腐脑等。……
你:Introduce the history of the United States, please.
它:您提到的「Introok's the believeations of theument.」这个名字来源于中国古代的「groty of of the change.」
三点感受:
- 第一问还算像样 —— 这说明它确实学会了「一问一答」这个格式,语言也是通顺的
- 第二问开始编 —— 杭州美食答成「鸡肉串、鳗鱼头」,这是典型的小模型幻觉:知道该用什么句式,但不知道内容该填什么
- 第三问直接崩了 —— 英文完全不成句,说明它的英文能力基本等于没有
作者自己也写得很直白:「尽管该版本已经具备基础对话能力,但事实知识与泛化效果仍较有限。」
这句话是整个 README 里最诚实的一句,也是我建议所有跃跃欲试的人先读的一句。
五、那它值不值得学
分人。我按三种情况给判断:
| 你是哪种人 | 值不值得 | 理由 |
|---|---|---|
| 想搞懂 LLM 到底是怎么运转的 | 非常值得 | 六万星的核心价值就在这。它把注意力、归一化、位置编码、损失函数全部摊开,一行行能看到 |
| 想给自己做一个能干活的小助手 | 不值得 | 64M 的模型做不了实际工作。这个需求应该找现成的小模型(几 B 参数的)做量化部署 |
| 想验证「我能不能训模型」这件事 | 值得 | 3 块钱、两三小时就能拿到确定答案,比你花三个月犹豫划算得多 |
一句话:拿它当教材,别拿它当产品。
六、真想上手,正确的做法是什么
如果你决定试,有几件事按这个顺序做能少踩坑:
1. 别在本地硬扛,直接租卡
自己的电脑如果是 8G、12G 的消费级显卡,那 24G 显存这一关就过不去。 云 GPU 按小时计费,跑一次两三小时、几块钱,这是这个项目最实际的地方。
2. 先跑通推理,再跑训练
项目发布了现成的权重(26M / 104M / 145M),先下载下来跑通一次对话, 确认环境没问题 —— 这一步几分钟。再回头去跑训练,出问题时你才能分清是环境的问题还是训练的问题。
3. 第一次就用 mini 数据集,别贪心
「2 小时」成立的前提是用项目自带的 mini 数据。一上来就想用自己的数据训练, 清洗、格式、配比每一样都是新坑,往往卡在数据上而不是训练上。
4. 一定要跑一次完整链路,然后停下来想
跑通之后最重要的不是「我训出来了」,而是回头看一眼:这几十行代码里,哪一段是你之前完全不懂的? 那个地方才是你这次真正的收获。
七、一条判断线
我把它压缩成一句话,方便你判断自己该不该投入时间:
| 你想得到的 | 该不该碰 MiniMind |
|---|---|
| 搞懂模型内部怎么运作 | 该 —— 同类项目里它最透明 |
| 做业务能用的 AI 功能 | 不该 —— 直接用 API 或现成开源模型 |
| 验证自己能不能训模型 | 该 —— 成本低到不试可惜 |
| 替代 ChatGPT / DeepSeek 那种能力 | 不该 —— 参数量差着三个数量级 |
八、最后
回到开头那个问题:普通人能不能搭建大模型?
我的答案是:能,但你搭出来的那个东西,不该被叫做「大模型」。
这不是文字游戏。参数量差 2700 倍,意味着它们能做的事根本不在同一层 —— 这就像说「我造了一辆车」,造的是一辆能跑的四驱遥控车,而对方说的是能上高速的 SUV。 两件事都值得骄傲,但把它们放进同一句话里,会让后来的人白走弯路。
但换个角度看,这件事的价值恰恰在「能亲手造一次遥控车」上。 绝大部分人对 AI 的认知停在「它是黑盒」,而这个项目把它拆成了你能读懂的几页代码。 理解一个东西怎么来的,是使用它的前提。
所以我推荐它,但要带着正确的预期去:不是为了得到一个模型,是为了第一次真正看懂一个模型。
这两个目标之间,差的不是 3 块钱,是你打算花几个小时。
本文数据依据 MiniMind 官方仓库(jingyaogong/minimind,截至 2026-10-31 的 64,537 stars)与 其 Hugging Face 模型页,硬件要求、训练耗时、成本口径及对话示例均引自项目 README 原文。