AI 时代,试错成本降的是哪一部分
一、先看一份「做不下去」的研究
要讲 AI 时代的试错成本,得从一个不太常被引用的结果讲起。
2025 年 7 月,非营利研究机构 METR 发布了一项随机对照实验。他们招募了 16 名资深开源开发者,来自平均 2.2 万星标、代码量超过百万行的知名项目 —— 都是在自己写了多年的代码库里干活。研究者让每人提交一批真实的任务(共 246 个,包括修 bug、加功能、重构),然后随机分配:一半允许用 AI 工具,一半禁止。
结果和所有人的预期相反:允许用 AI 的那一组,完成任务反而慢了 19%。
更微妙的是开发者的主观感受 —— 他们自己觉得快了 20%。客观测量和主观感受,方向完全相反。
这个结论当年被大量引用。但如果只引用到这里,就错了。因为 METR 在 2026 年 2 月发布了后续研究,而后续研究给出的数字是这样的:
| 研究阶段 | 参与对象 | 实测结果 | 置信区间 |
|---|---|---|---|
| 2025 年初(首次) | 16 名资深开发者 | 慢 19% | +2% ~ +39% |
| 2025 年下半年(后续) | 原班人马中的 10 人 | 快 18% | -38% ~ +9% |
| 2025 年下半年(后续) | 新招募的 47 人 | 快 4% | -15% ~ +9% |
同一批人、同一套方法,半年多时间,方向翻转了。
二、比数字更有说服力的是:这项研究本身做不下去了
而这还不是最有意思的部分。METR 在报告里写了一件事,比上面任何一个数字都更能说明问题 ——
他们发现,30% 到 50% 的开发者,会主动选择不提交某些任务。原因不是不会做,而是:他们不想在没有 AI 的条件下做这些任务。
报告里引了几位参与者的原话。有一位说:
「我发现自己其实在严重地挑任务 …… 我会避开那些『AI 两小时就能搞定、而我得花二十小时』的活。如果任务被判到禁用 AI 那一组,我会非常痛苦。」
另一位打了个比方:
「要我用老办法干太多活,我脑袋要炸了 —— 就像你习惯了打车穿城,突然让你全程走过去。」
还有一位受邀参加后续研究时这样回复:
「我很矛盾。我既想为这个研究提供更新的数据,但我又真的很喜欢用 AI。」
METR 因此坦承:参与者的筛选效应已经严重到让研究数据「不再是衡量 AI 对开发者生产力影响的可靠代理指标」,他们必须重新设计整个实验。
这里值得停一下。一个研究因为参与者拒绝退回「没有 AI」的状态而做不下去了 —— 这比任何百分比都更能说明成本结构发生了什么变化。当人们宁愿不赚那份实验报酬、也不愿意回到原来的工作方式时,这不是「工具好用了」的程度,这是基准线本身移动了。
三、降低的不是「开发成本」,是「放弃成本」
那么,AI 到底降低了试错成本的哪一部分?
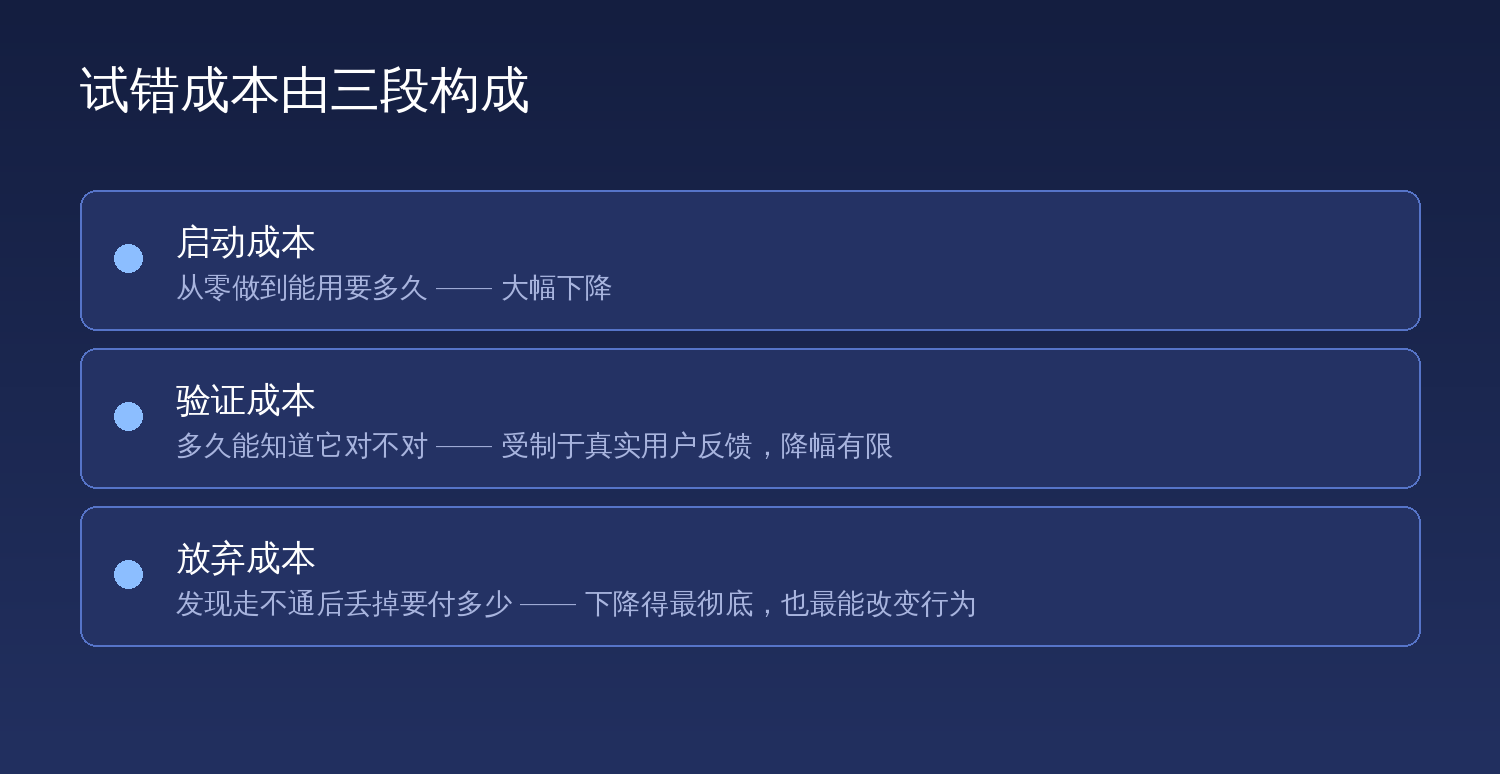
「试错成本」这个词经常被当成一个整体来用,其实它由三段构成:
| 构成 | 含义 | AI 的影响 |
|---|---|---|
| 启动成本 | 从零做到能用,要多久 | 大幅下降 |
| 验证成本 | 做出来之后,多久能知道它对不对 | 有所下降,但受制于真实用户反馈 |
| 放弃成本 | 发现走不通之后,丢掉要付出多少 | 下降得最彻底 |
多数讨论都集中在第一行。但真正改变行为的,是第三行。
道理很朴素:让人不敢开始的,往往不是「做不出来」,而是「万一做错了,那些投入怎么办」。过去一个项目投入到一半发现方向错了,前面几个月的人力、时间、机会成本全砸在里面,这种沉没成本会让一个组织和个人都倾向于「再撑一撑」—— 于是错误被拖长,直到无法挽回。
而 AI 生成的第一版代码,沉没成本极低。丢掉重来不心疼,因为本来也没花多少时间。当「放弃」变得便宜,「开始」就变得容易;而当「开始」变得容易,敢试的次数就会上升 —— 这才是所谓试错成本下降的真正机制。
这个判断在产业一线的感受里能得到印证。百度秒哒产品总经理朱广翔用「船小好掉头」来形容一人公司,他说创业者能快速决策、快速验证、快速试错,用最低的成本轻装上阵,即使失败也几乎没有损失。
更具体的数字来自一线的创业者:
| 来源 | 说法 |
|---|---|
| 机器人创业团队负责人陈宇亮 | 依托 AI 工具辅助,当天就可以完成方案验证与决策 |
| 一位一人公司创业者 | 如果发现商业模型失败就立马换,给一个产品的生命周期最长一个半月 |
| 中国科学院院士丁洪 | 以往需要 10 个人做一周的工作,在 AI 智能体助力下,只需几天甚至几个小时 |
「一个产品的生命周期最长一个半月」—— 这个数字值得单独体会。它意味着试错的周期和代价同时被压缩了:不是「试错变便宜了」,而是试错变成了一件可以连续做很多次的事。 以前一次试错的周期以年计,你一生能试的次数屈指可数;现在以月计,试错从一个决策变成了一种节奏。
四、必须说清的边界:AI 没有让「维护」变便宜
但前面 METR 的原始结论不能被跳过。它揭示的是另一面,而且这一面至今没有被推翻:
那 16 名开发者是在什么条件下变慢的?在自己写了多年、代码量超过百万行的成熟项目里。
| 场景 | AI 的实际作用 |
|---|---|
| 从零做一个新东西 | 极大幅度提升 —— 没有历史包袱,没有隐含约定 |
| 在成熟复杂的老代码库里改东西 | 可能反而更慢 —— 数据至今没有被推翻 |
原因不难理解:老代码库里大量关键信息是没有被写下来的 —— 为什么这里要这么写、哪段代码不能碰、这个绕过去的写法是为了规避什么。这些东西在老开发者的脑子里,不在文档里。AI 只能看到代码本身,看不到那些没写下来的部分。
所以更准确的说法是:AI 降低的是「从 0 到 1 的试错成本」,没有降低「从 1 到 100 的维护成本」。
还有第二层边界,同样来自权威报道。科技日报在调研一人公司时,点出了一批被反复提及的挑战:算力成本焦虑、数据安全、同质化竞争、社会信任度低、资源孤岛、制度空白。其中有几位创业者给了一个很实在的数字:
安装、调用 API 的算力支出,以及租用服务器、存储云资源的固定成本,已占公司运营总成本的一半以上。
换句话说,写代码那部分便宜了,但让代码跑起来的那部分没有便宜。过去是「人力贵、机器便宜」,现在在相当一部分场景里,这个关系正在反过来。此外报道里还提到一些更麻烦的问题:有创业者反映智能体会出具虚假的调研报告,误导业务判断 —— 这比单纯做错了更危险,因为它让你在错误的判断上更加笃定。
五、那么,正确的用法是什么
把上面几件事合起来,能得到一个相当明确的操作结论:
| 阶段 | 怎么用 AI | 理由 |
|---|---|---|
| 验证阶段(0 → 1) | 尽量用,快速做出来给人看 | 这一步的成本几乎降到底,多试几次是划算的 |
| 维护阶段(1 → 100) | 谨慎,不要在你不懂的地方放权 | 原始研究显示这里可能反而变慢 |
| 判断阶段 | 不能交出去 | 方向错了,做得越快越亏 |
回到开头那个判断 —— 「AI 时代软件项目开发的试错成本在降低」。这话站得住,而且比刚说出来的时候更有依据:METR 那份研究的两个阶段,恰好把这个变化过程本身记录了下来(从慢 19% 到快 18%)。
但有一件事需要分清楚:试错成本降低,不等于成功的概率变高。 它改变的是你能承担多少次失败。
以前一个人只有一次试错机会,所以那一次必须选对;现在能试十次,那么真正的能力就变成了 —— 知道该把十次机会花在哪些方向上。 工具降低了每一次的价格,但没有降低「选错方向」这件事本身的代价。
省下来的试错成本,最终会流向判断力。这一点,才是这个变化真正的分量所在。