这一周 AI 圈:智能体的三块拼图同时到位
一、先看结论
这一周(10 月 14 日至 21 日)AI 圈的新闻看着很杂:有开源模型、有智能体手机、有接口收费、还有一家明星公司申请破产。
但把它们摆在一起看,会发现其实是同一件事的三个侧面——
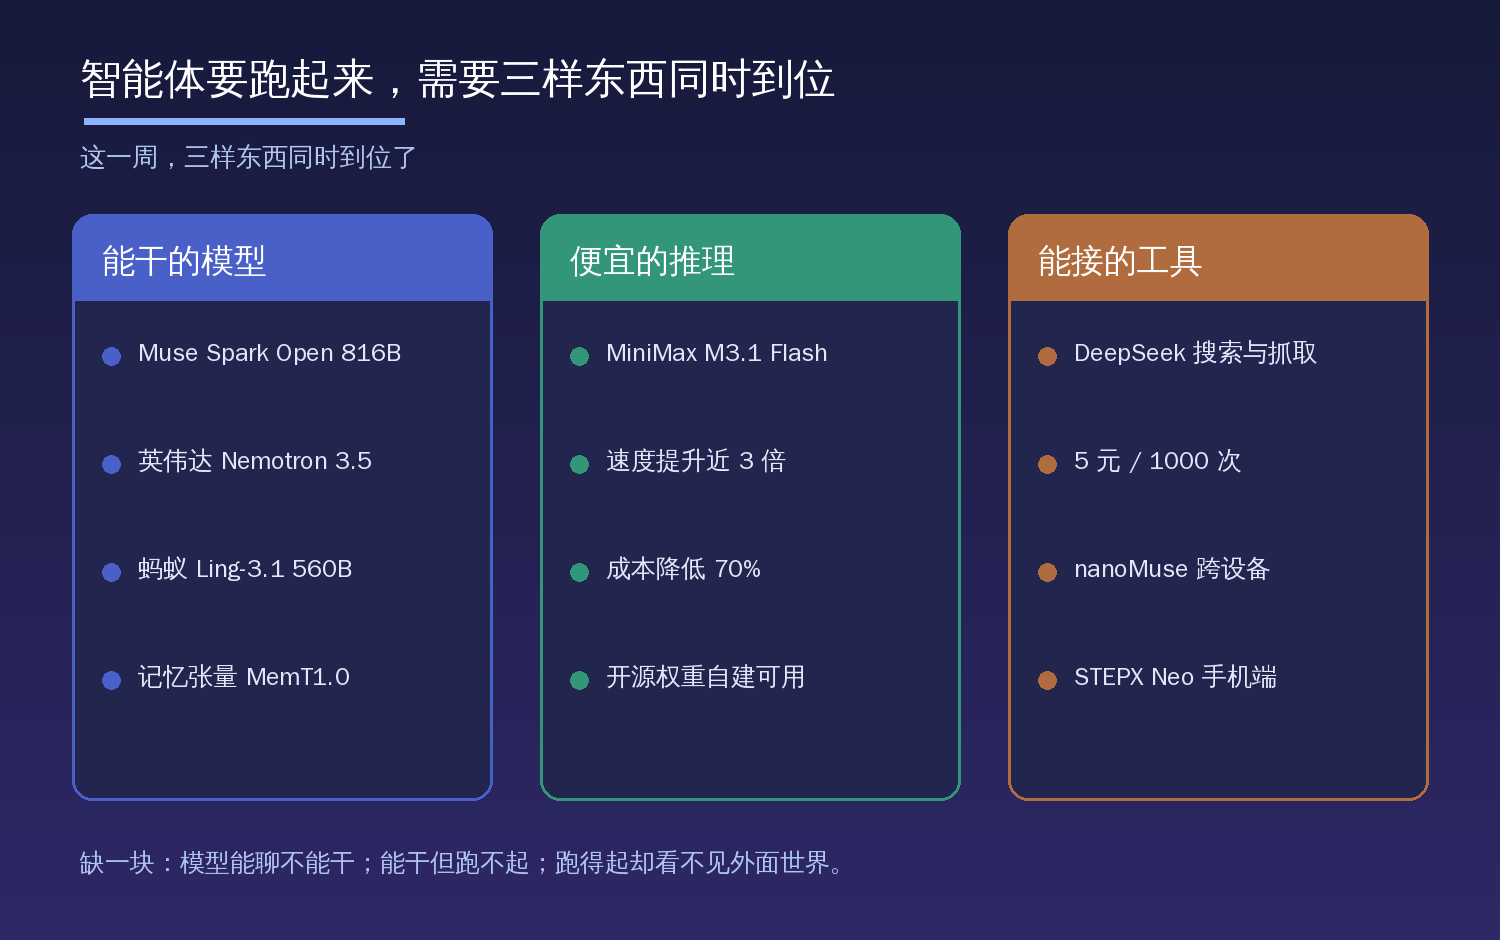
一个智能体要真正跑起来,需要三样东西同时到位:能干活的模型、便宜到可以反复试错的推理、能接入外部世界的工具。
缺一样会发生什么,很清楚:模型能聊不能干;能干但跑不起;跑得起却看不见外面的世界。
而这一周,三样东西同时到位了。下面一条条说。
二、主线一:开放权重模型集中开闸
这一周的开放权重模型发布密度,是今年少见的。四家在同几天里各放出一个:
| 模型 | 发布方 | 参数规模 | 上下文 | 值得注意的点 |
|---|---|---|---|---|
| Muse Spark Open | Meta | 816B(激活 42B) | 100 万 token | 原生多模态,官方称「美国最强开放权重模型」 |
| Ling-3.1-flash | 蚂蚁百灵 | 560B(激活约 25B) | 最高 100 万 token | MXFP4 量化后权重 534GB 降到 292GB,4 张卡可部署 |
| MemT1.0 | 记忆张量(中国团队) | 288B / 36B 两档 | — | 把「记忆」做进模型计算,不必每次重喂历史 |
| Nemotron 3.5 Super VL | 英伟达 | 120B | — | 面向常驻企业智能体与边缘设备,另有 Bolt 系列 |
四个模型的技术路线不同,但有三个共同点,值得单独拎出来:
第一,都在往百万级上下文走。Meta 和蚂蚁这两家都做到了 100 万 token。这个量级的意义不在于「能塞进一本书」,而在于智能体可以带着一整个项目的代码和几周的对话历史去干活,不用每次从零开始理解。
第二,都在压缩部署成本。蚂蚁那个模型权重从 534GB 压到 292GB,4 张卡就能跑——这条比参数量重要。一个 560B 的模型如果只能在机房里跑,对绝大多数团队等于不存在;能装进 4 张卡,才谈得上真正被用起来。Meta 这边也有人在两台 Mac Studio 上跑通了。
第三,评测口径在换。以前比的是考试分数,现在越来越多拿 智能体任务来比。这说明行业自己也认为,能答题和能干活是两回事。
三、主线二:智能体从「能聊」走向「能替你做」
这一周有两个项目特别值得看,一个开源、一个硬件。
(一)nanoMuse:浙大开源的个人智能体
浙江大学 APRIL 实验室开源的 nanoMuse,论文《nanoMuse: An Open-Source Personal Agent for Every Device You Own》(面向你所拥有的每一台设备的开源个人智能体),10 月 8 日登上了 Hugging Face Daily Papers 当日榜第三。
它要解决的问题很具体:你手上的设备是散的——手机、电脑、平板各有各的东西,你要找一份文件、跑一个任务,得自己在几台设备之间来回倒腾。
nanoMuse 的做法是让这些设备连起来:你在手机上交代任务,由在线的电脑去执行,再把结果和「需要你批准的操作」送回手机。
这里有个设计值得留意——需要你批准这一步。敏感操作不自己做主,要回到人手上确认。个人智能体最大的顾虑从来不是能力够不够,而是它替你做的事你敢不敢放手。把确认环节显式做进流程,比单纯提升能力更能让人接受。
它同时也是对 Meta 在 9 月发布的 Muse 的开源回应。Muse 走的是把个人智能体放在厂商云端虚拟机上、封闭运行的路子;nanoMuse 选择开源、跑在用户自己的设备上。两条路的根本分歧是:这个替你办事的智能体,到底归谁管。
(二)STEPX Neo:把智能体做成操作系统
10 月 13 日,阶跃终端发布了首款大模型原生智能体手机 STEPX Neo,全栈价 3999 元。
它的特别之处不在硬件参数,而在系统——搭载的 Step AOS 1.0 是「智能体原生」的操作系统,配一个叫「阶跃 Amoo」的个人智能体。
交互方式变了:你提需求,由智能体去协调系统和应用完成任务,而不是你去一个个打开应用、一层层点进去。
发布会本身也是个信号——整场大幅压缩了传统硬件参数宣讲环节。这说明厂商自己也在赌:这一代产品的卖点不在跑分,在「它替你干掉了多少点击」。
四、主线三:成本断崖与工具链补齐
(一)DeepSeek 搜索与抓取落地按次计费
这条是本周最影响开发者的一条,值得说细一点。
10 月 18 日,DeepSeek 发布公告:DeepSeek API 现已支持网页搜索与抓取,按请求次数计费,单价为每 1000 次成功请求 5 元。
关键信息有三条:
| 项目 | 内容 |
|---|---|
| 生效时间 | 北京时间 2026 年 11 月 1 日 00:00 |
| 此前状态 | Search / Fetch 接口调用一直未计费 |
| 计费口径 | 每 1000 次成功请求 5 元;两个接口都由 DeepSeek 自研搜索引擎驱动 |
还有一个背景需要知道:如果你在用 DeepSeek Harness、Claude Code、Codex 这类工具接入 DeepSeek API,它们已经在通过服务端工具调用访问 Search / Fetch 接口了。也就是说,这笔钱不是「你主动去用了才产生」,而是只要你在用这些工具,11 月 1 日之后就会自然开始计费。
为什么这件事重要?因为「能联网」是智能体和聊天机器人之间的分水岭。不联网的智能体只能靠训练时的记忆回答,你问它今天的行情、最新的价格、刚发布的公告,它只能瞎猜或者拒答。接上了搜索与抓取,它才真的能去外面看一眼再回来告诉你。
而 5 元 1000 次这个价格,意味着一次搜索半厘钱。这个量级已经低到「不需要为它做成本设计」的程度——一个任务里搜个十次二十次,成本可以忽略不计。低成本会改变产品设计,这才是这条新闻的真正影响。
给用得上的人提个醒:如果 11 月 1 日之后月度预算敏感,最好在生效前先看一眼自己的调用量,尤其是那些自动化跑着的任务。另外,各家对「成功请求」的判定口径不完全一样,建议以官方价格页面为准,别按调用次数直接乘。
(二)MiniMax M3.1 Flash:速度与成本同时下调
10 月 19 日前后,MiniMax 发布了新一代 Flash 模型 M3.1 Flash:推理速度提升近 3 倍,成本降低 70%。
有个细节挺有意思:此前在评测场上以匿名身份跑了很久的那个 Space Bunny 模型,处理了超过 200 万亿 Token,后来揭晓正是 M3.1 Flash 的早期版本。先匿名放出去让人用、再揭晓身份,正在成为国内厂商验证模型的一种常见做法——真实使用数据比排行榜更能说明问题。
速度和成本同时下调,对智能体是双重利好。因为智能体天生要多轮调用:想一步、调一次工具、看结果、再想一步。以前一次任务调用十几次,成本和时间都让人犹豫;现在才真正变得「可以随便试」。
五、三件事为什么是一件事
把上面三条线并排放在一起,关系就很清楚了:
| 拼图 | 这一周发生了什么 | 解决了智能体的哪个问题 |
|---|---|---|
| 能干的模型 | 816B / 560B / 288B 集中开源,百万上下文成标配 | 它够不够聪明、能不能装下整件事的上下文 |
| 便宜的推理 | 速度提升近 3 倍、成本降 70%;开源权重让自建成为选项 | 能不能反复试错,而不是一次定生死 |
| 能接的工具 | 搜索抓取按次计费、单价低到可以忽略;跨设备调度开始出现 | 它看不看得见外面的世界、能不能真的动手 |
单看任何一条都不算颠覆。但三条同时到位,性质就变了——智能体从「演示品」变成「可以天天用的东西」,靠的不是某一次能力跃升,而是这三块短板一起被补上。
这也解释了一个很多人有的困惑:为什么 AI 智能体喊了这么久,真正用起来还是最近的事。答案不在模型不够聪明,而在另外两块拼图一直没到位——推理太贵,试错成本高;接口拿不到,看不见外面。这两样补上之后,原先卡住的应用场景会一批一批地通。
六、一条值得留意的提醒
这一周还有一条画风完全不同的新闻:Character.AI 于 10 月 12 日在美国特拉华州联邦破产法院申请第 11 章破产保护,并启动法院监督下的资产出售程序。迪士尼以「白衣骑士」身份出价 2000 万美元,竞购部分知识产权。
从公开的法庭文件看,原因很具体:融资受阻、月度运营亏损约 800 万至 900 万美元,加上未成年人保护相关的诉讼持续施压。公司预估资产和负债规模均在 5000 万至 1 亿美元之间。
这条新闻不需要过度解读,但它说明了一件事:模型能力和商业模型是两件事。
一家公司的产品可以很受欢迎、用户量很大,但如果每次对话都在烧钱、又没有清晰的付费路径,规模越大亏得越快。再叠加上合规风险,一个爆款可能转眼就成了负资产。
对做 AI 应用的人来说,值得对照自己手上在做的事问一句:这个东西用户是真的愿意付钱,还是只是愿意用?这两者之间的差距,往往要用一两年时间和一轮融资才能看清。
七、下周看什么
- 11 月 1 日 00:00,DeepSeek 搜索与抓取正式计费——如果你的项目在跑自动化,这之前把用量盘一遍。
- 开源权重模型的「可部署性」会不会继续下探。这一周 4 张卡跑 560B,下一周会不会变成 2 张卡跑更大模型。
- 智能体手机的交互到底能不能立住。参数已经不是卖点,接下来比的是「真的替用户省了多少步骤」。
- nanoMuse 这类开源个人智能体的生态能不能起来。开源路线的关键从来不是第一个版本,而是有没有人跟着一起做。