用 AI 逆向别人的作品:能做什么,不能做什么
前面几篇聊的都是「有个想法,让 AI 帮你实现」。但这件事有一个自然的延伸,很多人已经在做了:看到一个做得很好的东西,没有源码,于是让 AI 根据功能反推,把源码写出来。
这条路是真实存在的,而且 AI 确实把它变得容易了很多。但它和「把想法实现出来」有一个根本区别:你要实现的那个东西,可能不属于你。
所以这篇不绕弯子,直接把线画清楚:什么可以做、什么不可以做、怎么做才算走在正路上。
一、先分清你在做哪一件事
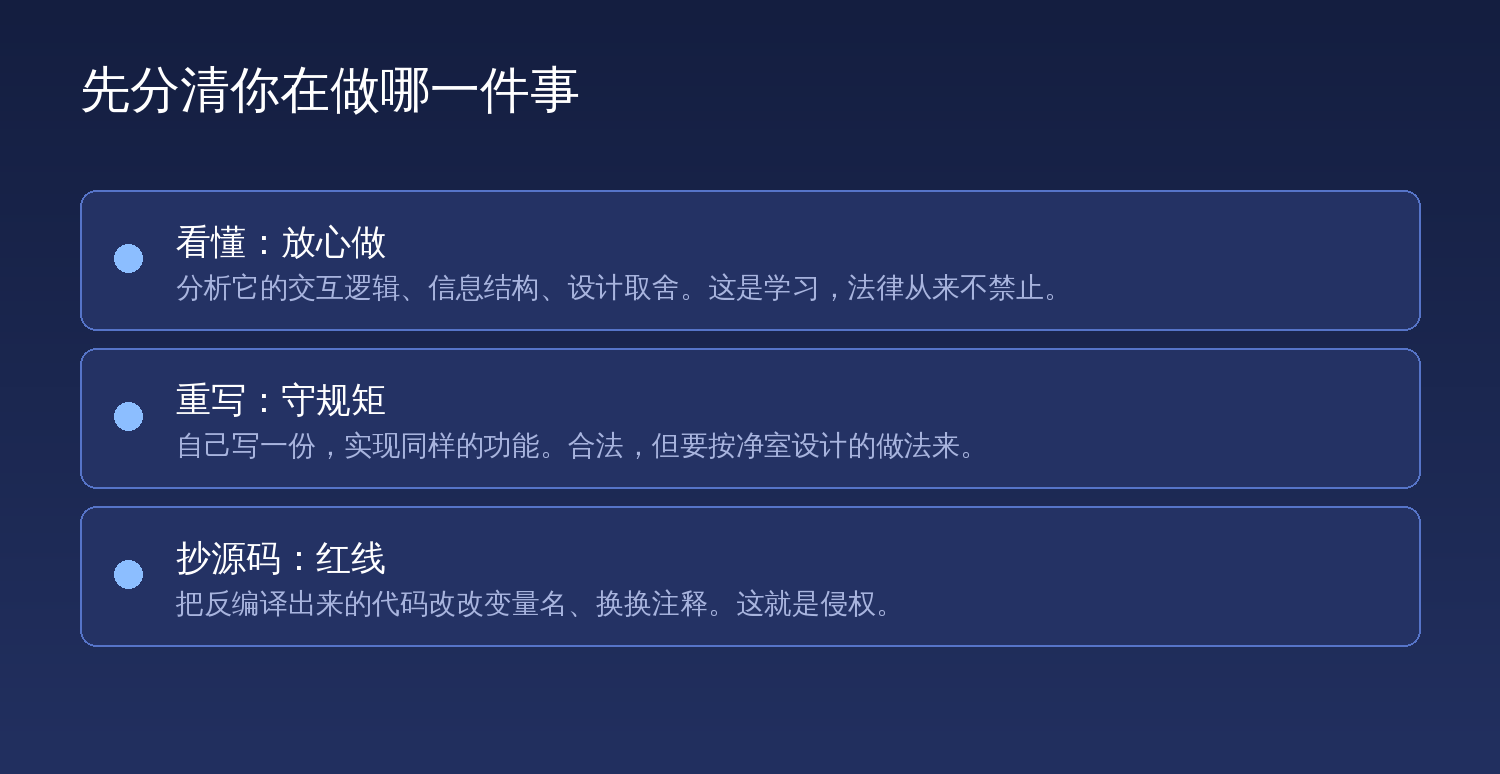
这三件事经常被混为一谈,但性质完全不同。
| 你在做什么 | 性质 | |
|---|---|---|
| 看懂 | 分析它的交互逻辑、信息结构、设计取舍 | 这是学习,法律从来不禁止 |
| 重写 | 自己写一份,实现同样的功能 | 合法,但要按规矩来 |
| 抄 | 把反编译出来的代码改改变量名、换换注释 | 这就是侵权 |
中间那一行是最容易出事的:「我自己重写」和「我把别人的代码改一改」之间的界线,比看起来要细。下面会讲法院到底看什么。
二、AI 把这件事变容易了多少
说句实话:变容易了非常多。
以前想把一个没有源码的软件「看懂」,得反编译出一堆汇编或者被混淆过的代码,再一层层还原,是少数人才能干的活。现在你把功能描述给 AI,它能直接给你一份能跑的实现。
但这里有一个关键认识,我把它放在最显眼的位置:
AI 降低的是「实现成本」,不是「法律成本」。
这条法律线不会因为工具变强而向后退一步。工具越强,越要自觉。
换个说法:以前你抄不动,是因为你写不出来;现在你写得出来了,但「写不写得出来」从来不是判断侵权的标准。
三、法律上这条线画在哪
好消息是,法律对这件事的态度比很多人以为的要清楚。按三个层次看。
第一层:法律明文允许反向工程
2020 年修正的《中华人民共和国著作权法》第五十条列了几种「可以避开技术措施」的情形,其中第五项原文是:
进行加密研究或者计算机软件反向工程研究。
也就是说,「计算机软件反向工程研究」在我国法律里是被明确列为正当情形的,不是灰色地带。
第二层:为了兼容而读别人的格式,不构成侵权
最高人民法院指导案例 48 号,是北京精雕科技有限公司诉上海奈凯电子科技有限公司侵害计算机软件著作权纠纷案(2015 年 4 月 15 日发布)。
案情大意是:精雕把自己的软件输出文件做成加密的特定格式,用来阻止别家软件读取,从而维持软件和自家雕刻机的捆绑销售。法院认为,这是为了实现捆绑销售而设置的技术限制,不属于著作权法所规定的技术措施;奈凯开发软件读取该输出数据,不构成侵权。这个案例的关键词里,甚至有「权利滥用」。
这条判例的意义很直接:「别人不让你兼容」和「法律不让你兼容」是两回事。
第三层:反向工程可以,复制不行
反过来的一面也有明确案例。最高人民检察院第四十八批指导性案例(检例第 194 号)指出:通过反向工程获取芯片中的二进制代码后,未经许可以复制二进制代码的方式制售权利人芯片的,应认定为复制发行计算机软件行为,违法所得数额较大或有其他严重情节的,以侵犯著作权罪追究刑事责任。
三层放一起看,结论很清楚:
| 事情 | 结论 | |
|---|---|---|
| 1 | 做反向工程研究本身 | 法律明文允许 |
| 2 | 为兼容而读取输出格式 | 不构成侵权,对方拦不住 |
| 3 | 复制别人的代码去制售 | 可能构成犯罪 |
四、法院真正在看什么:「接触 + 实质性相似」
这是软件著作权侵权认定里最核心的一条规则,也是你自查时最好用的一把尺子。
| 要件 | 说的是什么 | 放在 AI 逆向这件事上 |
|---|---|---|
| 接触 | 你有没有机会看到原作 | 你反编译过,你「接触」过了 |
| 实质性相似 | 你交出来的东西和原作像不像 | 代码结构、函数命名、注释、变量、错误处理方式像不像 |
两个要件同时成立,就很可能被认定侵权。
这里有个反直觉但很重要的点:「接触」这一条,从你决定去反编译的那一刻起就已经满足了。所以真正决定成败的,全在第二条——你做出来的东西像不像。
而 AI 恰恰在这里有风险:你如果把反编译结果贴给它,让它「照着写一个差不多的」,它产出的代码结构、命名习惯、甚至注释风格都可能高度接近原作。这在法律上非常危险。
五、可以放心做的五类事
| 场景 | 为什么可以 |
|---|---|
| 学习设计思路 | 交互逻辑、信息架构、功能取舍属于思想层面,著作权保护表达不保护思想 |
| 做兼容与互操作 | 最高院指导案例 48 号已明确边界 |
| 安全研究 | 《著作权法》第五十条还把「加密研究」一并列为可避开技术措施的情形 |
| 竞品功能分析 | 把功能拆成需求,这是产品工作的一部分 |
| 按要求独立重写 | 走净室设计流程,见下一节 |
六、必须避开的三条红线
| 红线 | 具体表现 |
|---|---|
| 直接复制代码 | 反编译出来改改变量名、换换注释就用——这是最典型也最容易认定的侵权 |
| 把原代码喂给 AI 让它「改一改」 | 换汤不换药,产出物与原作实质性相似,风险极高 |
| 以不正当手段拿到的东西 | 《最高人民法院关于审理不正当竞争民事案件应用法律若干问题的解释》第十二条说得很清楚:反向工程指的是对从公开渠道取得的产品进行拆卸、测绘、分析;以不正当手段知悉他人技术信息之后,再以反向工程为由主张合法,法院不予支持 |
还有一条容易被忽略:净室设计能规避著作权,但不能规避专利。如果对方有专利,独立重写也一样绕不过去。这一点开工前要查。
七、正确姿势:净室设计
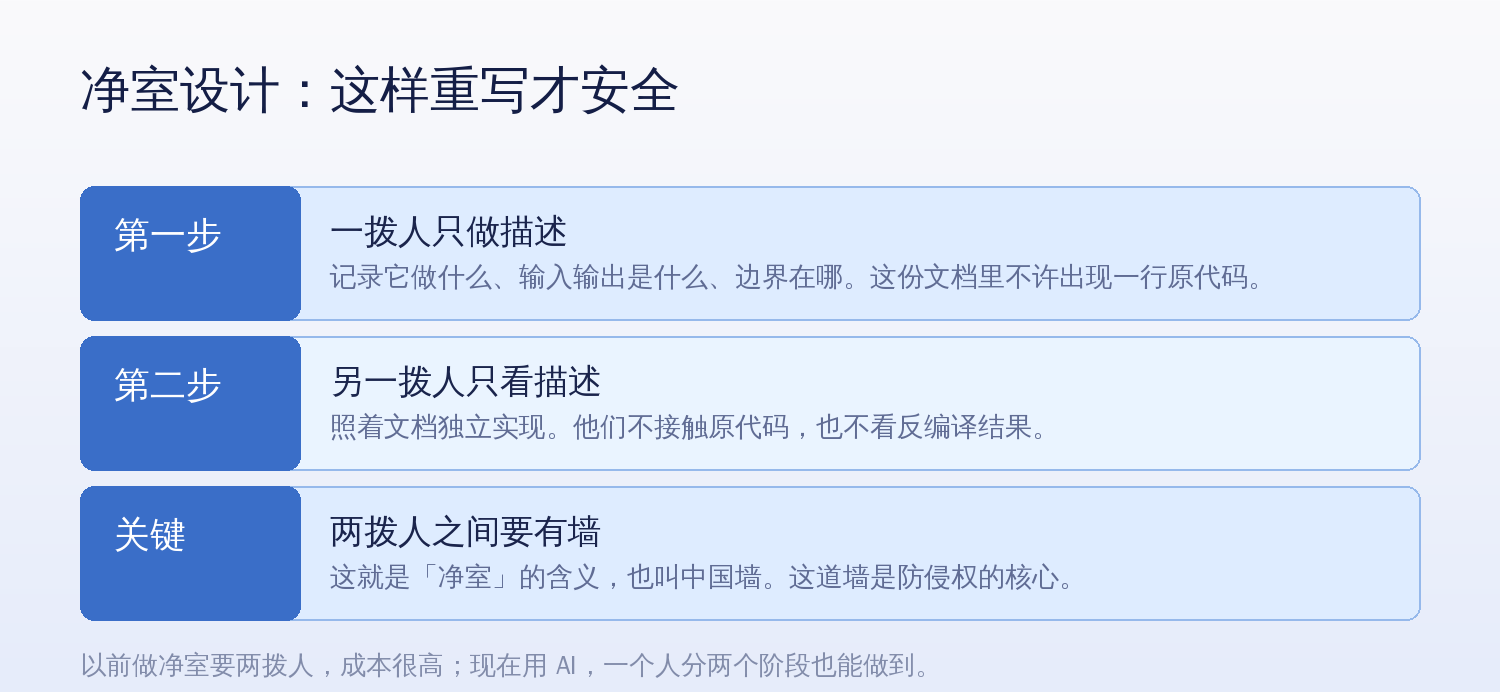
「净室设计」是一套成熟的做法,也叫「中国墙技术」。它的原理很简单:把「理解别人的东西」和「写自己的东西」这两件事,在不同的人之间隔开。
| 步骤 | 做什么 | 要守住什么 |
|---|---|---|
| 一 | 一拨人只做描述:记录它做什么、输入输出是什么、边界条件在哪 | 这份文档里不许出现一行原代码,只写行为,不写实现 |
| 二 | 另一拨人照着文档独立实现 | 他们不接触原代码,也不看反编译结果 |
| 三 | 两拨人之间保持隔离 | 这道墙就是防侵权的核心,也是「净室」这个名字的来源 |
净室设计之所以被认可,是因为它立足于独立创作,而不是「改别人的」。法院认定侵权看的是实质性相似,而独立创作的产物天然就没有这个问题。
八、AI 反而让净室设计第一次变得可行了
这一节是我最想说的。
净室设计是个好东西,但过去有个现实障碍:它需要两拨人。对小团队和个人来说,成本高到根本不可能执行——哪来的两拨人?
AI 改变了这个前提。因为「照着文档写实现」这件事,正好是 AI 最擅长的。
所以现在一个人也能做净室,只要严格分阶段:
| 阶段 | 你做什么 | 绝对不能做什么 |
|---|---|---|
| 第一阶段 | 只分析、只记录,产出一份纯粹的功能规格文档 | 不写代码,不把反编译结果贴给 AI |
| 切断 | 关掉原代码,清干净上下文 | 不要带着「原实现的样子」进下一阶段 |
| 第二阶段 | 只把规格文档给 AI,让它从零实现 | 不回头对照原代码 |
关键在于第二阶段的输入里,只有「它要做什么」,没有「它原来是怎么做的」。做到了这一点,你产出的就是一份独立实现,而不是一份改写。
真正的分界不在你用了什么工具,而在你交给 AI 的输入里,有没有混进别人的表达。
只给行为,就是净室;给了代码,就可能是侵权。
九、回到最开始那件事
前面几篇一直在说:AI 让想法变得值钱,让实现变得便宜。这个判断在这里同样成立,只是多了一层约束。
逆向这件事,真正有价值的部分从来不是拿到一份源码,而是搞懂别人为什么这么做——他为什么这样分模块,为什么这个功能放在这个位置,为什么在某个地方绕了一下。
这些是思想和经验,是法律明确不保护的、也正是你该学的。而代码本身,你自己写一份就行,现在这件事已经很便宜了。
所以最划算的做法,恰恰也是最安全的做法:学它的思路,写自己的实现。